Scaling Law 为语言模型预训练指明了一条明路: 模型参数够大,计算资源够多,训练数据都扎实,就可以不断训练出一个更强的模型。但是,在 scaling 的路上,有许多工程上和算法上的阻碍需要被攻克,其中一个关键问题就是: 模型训练的并行化,如何将一个千亿参数的大模型的大规模训练,放到一个庞大的 GPU 集群上,充分榨干硬件的计算性能?
Baseline
我们首先来算一笔显存账: 以混合精度训练 + AdamW 为例,一个 7B(70 亿)参数模型的显存占用:
| 组成 | 每参数字节 | 7B 模型总计 |
|---|---|---|
| FP16 参数(前向/反向用) | 2 | 14 GB |
| FP16 梯度 | 2 | 14 GB |
| FP32 主权重(优化器更新用) | 4 | 28 GB |
| FP32 动量 | 4 | 28 GB |
| FP32 方差 | 4 | 28 GB |
| 小计(不含激活) | 16 | 112 GB |
- FP32 主权重是在执行梯度更新时候使用
- FP16 主权重是在计算前向梯度 && 做反向传播的时候使用
- FP32 的动量和方差的运算是 AdamW 优化器计算需要的
因此,在一个 Batch (or Mini-Batch) 中,训练具体流程是这样子的:
- Forward-Pass: 做 Next-Token-Prediction, 计算 cross-entropy-loss(pytorch 构建计算图)
- Backward-Pass: 做反向传播,从 loss 计算对应的梯度
- Weight Update: 使用优化器,将梯度更新到参数
GPU 通信: Basis
因为下文涉及多机多卡训练,因此下文首先介绍基本的 GPU 通信相关术语。理解他们的关键在于两个核心问题:
- 每张 GPU 一开始持有什么数据?
- 通信完成后,每张 GPU 最终得到什么数据?
All_Reduce
所有 GPU 求和,所有 GPU 得到完整结果。
例如 4 张 GPU 上分别有张量 , 然后 GPU 进行 All-Reduce 求和,得到完整结果 ,计算结果被同步到 4 张 GPU 上。
Reduce_Scatter
所有 GPU 求和,但是结果分片存储。
例如 4 张 GPU 上分别有张量 , 然后 GPU 进行 Reduce-Scatter 求和,得到完整结果 ,但是此时每个 GPU 上只拿到一部分的计算结果。比如如果求出来的张量是一个 的二阶张量,那么这个时候每个 GPU 只拿到 的计算结果。
All_Gather
把不同 GPU 上的数据收集起来,让每卡得到完整数据。
All-gather 和 Reduce_Scatter 是正好相反的过程,每个 GPU 上只有局部数据,通过 All-gather 获得全局数据,更新到每张 GPU 上。
Ring Communications
我们使用基本的 Ring 来做 GPU 数据通信的建模。
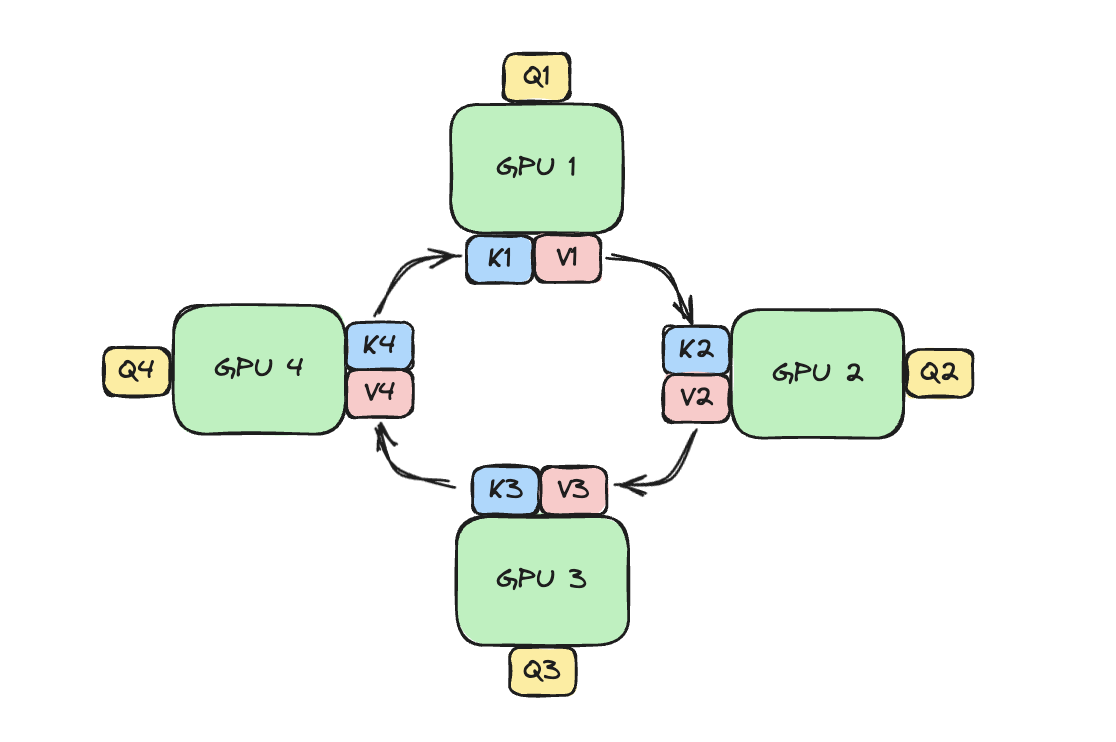
假设每个 GPU 都有一个大小为 的 Tensor。我们将每个 Tensor 切成 个 Chunk,每个 Chunk 的大小就是:
在每轮通信中,每张 GPU 向相邻 GPU 发送一个 Chunk,同时从另一个相邻 GPU 接收一个 Chunk。
- Ring Reduce Scatter:
- 需要 N-1 轮通信,让每张 GPU 都获得全部的数据, N 为 GPU 的数量,每一轮通信数据是 , 因此通信量计算就是 (假设 Chunk 的数量就是 GPU 的数量)
- All Gather:
- 每张 GPU 在初始都有自己的一个 chunk,为了收集别的数据,需要做 次通信轮转得到剩下 个 Chunk,因此通信量也是
- All Reduce:
- All Reduce 可以被看作是 Ring Reduce-Scatter + Ring All-Gather
- Ring Reduce-Scatter: 每个 GPU 都存储 N 个 chunk 的信息 (不同 GPU 相同位置的 chunk 数据),计算平均值 (1 chunk)
- Ring All-gather: 将所有的 Chunk 收集起来
- 因此通信量
- All Reduce 可以被看作是 Ring Reduce-Scatter + Ring All-Gather
DP/DDP
我们首先介绍最基础的数据并行 (Distributed Data Parallel), 每张卡保存一份完整的模型副本,把训练数据按 batch 维度切成 N 份,每卡处理不同的一批数据,各自独立地做前向、反向,得到各自的梯度。
也就是说,在 DP 中,每张 GPU 都需要存储 112GB 的内容,只不过每张显卡上运行的 batch 训练数据不同,因此得到的梯度也不同,在做梯度更新时,不同 GPU 需要做一次 All-Reduce:
来对梯度进行一次平均,然后将平均后的梯度传递给每一张卡上同步做 weight update,不同模型上保存模型参数保持相同。 DP 的工程优化:
- PyTorch DDP 通常在 Backward 期间按 Gradient Bucket 触发 All-Reduce,而不是等所有梯度计算完成后才统一通信。 因此可以实现 Communication-Computation Overlap。
- Mini-Batch 的思路,考虑显存使用,每张 GPU 连续处理 8 个 Micro-Batch,累积梯度,最后同步并执行一次参数更新 DP 存在的问题:
- DP 本质上就是提高数据吞吐的并行化手段,本质就是提升了 Batch Size
- 每一张 GPU 上都有一个同步更新的模型权重,存在冗余存储
ZeRO
Rajbhandari, Rasley, et al_. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models._ SC 2020. arXiv_:1910.02054_
为什么会有冗余?因为 DDP 里"模型 + 梯度 + 优化器状态"这些训练状态在每张卡上都各存一份,但它们在每张卡上内容完全相同。ZeRO(Zero Redundancy Optimizer)的思路是:把一份完整的状态切开,分到 N 张卡上各存 1/N,谁要用谁再临时取回来,从而让 N 张卡合起来只存一份。
假设参数量为 , 则在 DP 中,每张卡需要存储:
- FP16 参数
- FP16 梯度
- FP32 优化器状态
ZeRO-1 && ZeRO-2
我们首先对最大占用的优化器动手,切分优化器状态 。优化器状态(FP32 主权重、动量、方差)按参数分块,每卡只存自己负责的 1/N;参数与梯度仍然每卡全量保留
因为 FP16 的参数仍然在每张卡上保留,因此每张卡都可以对自己卡上的数据执行独立的前向计算和反向传播,产生梯度。接着做一次 All-Reduce 得到平均梯度,但是 weight update 的过程会放在每张卡上单独进行:
- 因为优化器被切割储存,因此每张卡只负责根据梯度进行特定区域的 weight update
- Zero1 带来的开销: 在完成梯度更新后做一次 All Gather,所有卡上的 FP16 模型参数都更新。
Zero1 的通信优化: 我们知道 All Reduce = Ring Reduce-Scatter + Ring All-Gather,因此,zero-1 得到梯度后,先做一次 reduce scatter,此时每张 GPU 都获得自己负责部分的参数梯度数据,此时再根据这些数据对本地做优化器更新和 weight update,然后将更新优化后的参数通过 all-gather 进行传递转移。Zero-1 此时的通信数量和 DDP 保持一致!
因此,针对 Zero1 的通信优化,我们叫他 Zero-2: 反向传播时用 Reduce-Scatter 代替 All-Reduce, 一次性完成"求平均 + 按卡切分"两件事,每卡最终只拿到自己负责的那 1/N 梯度,再用本卡的梯度 + 本卡的优化器状态更新本卡负责的参数。
Effectively this is a Reduce-Scatter operation, where gradients corresponding to different parameters are reduced to different process. To make this more efficient in practice, we use a bucketization strategy, where we bucketize all the gradients corresponding to a particular partition, and perform reduction on the entire bucket at once. (Zero-2, https://ar5iv.labs.arxiv.org/html/1910.02054)
也就是说,在 Zero-2 上,每张 GPU 的完整计算梯度不会保留,而会即刻实时传递到对应负责的 GPU 数据上。
ZeRO-3
ZeRO-3 是一种更加激进的并行化 DP 策略,FP16 的参数,每张卡上也只存一部分。但是带来的缺陷是:前向计算某个层之前必须先 All-Gather 把该层完整参数收集到本卡,算完该层就释放;反向传播时再对该层梯度做 Reduce-Scatter,把 1/N 梯度存回本卡。逐层"即取即用"。
因此 Zero-3 需要做 3 次通信:
- Forward All-Gather:获取当前层的完整 Weights,执行前向计算。
- Backward All-Gather:重新获取当前层的完整 Weights,执行反向传播。
- Backward Reduce-Scatter:聚合并分发 Gradients,每张 GPU 只保留自己负责的梯度分片,随后执行本地 Optimizer Step。
需要增加 50% 的通信成本。
FSDP
FSDP(Fully Sharded Data Parallel)是 PyTorch 提供的一种分布式训练技术,在原理上和 Zero-3 高度对应,不同的参数被分片存储到不同的 GPU 上。
参考: https://docs.pytorch.org/docs/2.14/distributed.fsdp.fully_shard.html
Model Parallel
在 Data Parallel,我们学习了如何将不同的训练数据放在不同的 GPU 上,并且在每张 GPU 上独立的做前向/反向计算,并通过 GPU 通信同步所有 GPU 的状态。但是,随着模型参数进一步增大,“每张 GPU 上独立的做前向/反向计算” 这件事情本身会造成很多阻碍:
- 模型参数大到一张卡上放不下
- 超长上下文,导致一张卡上无法完成完整的计算
因此,此时需要真正地把模型按结构切开分布到多张卡上协同训练——这就是模型并行。按切分维度不同,模型并行分为:沿隐藏维切(张量并行 TP)、沿序列维切(序列并行 SP、上下文并行 CP)、沿层切(流水线并行 PP)、沿专家维切(专家并行 EP)。以下内容整理自 HuggingFace 开源书《The Ultra-Scale Playbook》(https://huggingface.co/spaces/nanotron/ultrascale-playbook),配图均取自该书。
Tensor Parallel
TP 的数学基础是矩阵乘法的可拆分性:一个矩阵乘法既可以按列拆、也可以按行拆,分别算完再合并:
对应到神经网络 :
- 列切分(column-parallel)把权重按列切开,输入 在各卡复制(broadcast),各卡先算局部结果,再用 all-gather 拼回完整输出;
- 行切分(row-parallel)把权重按行切开,输入也要先切分(scatter),各卡算完后用 all-reduce 求和。
Tensor Parallel for FFN layer
The feedforward part can be parallelized by having a column-linear followed by a row-linear split, which amounts to a broadcast to copy the input and an all-reduce in the forward pass. Note that the broadcast isn’t needed in actual training, where we can make sure inputs are already synced across TP ranks. This setup is more efficient than starting with a row-linear followed by column-linear split, as we can skip the intermediate all-reduce between the split operations.
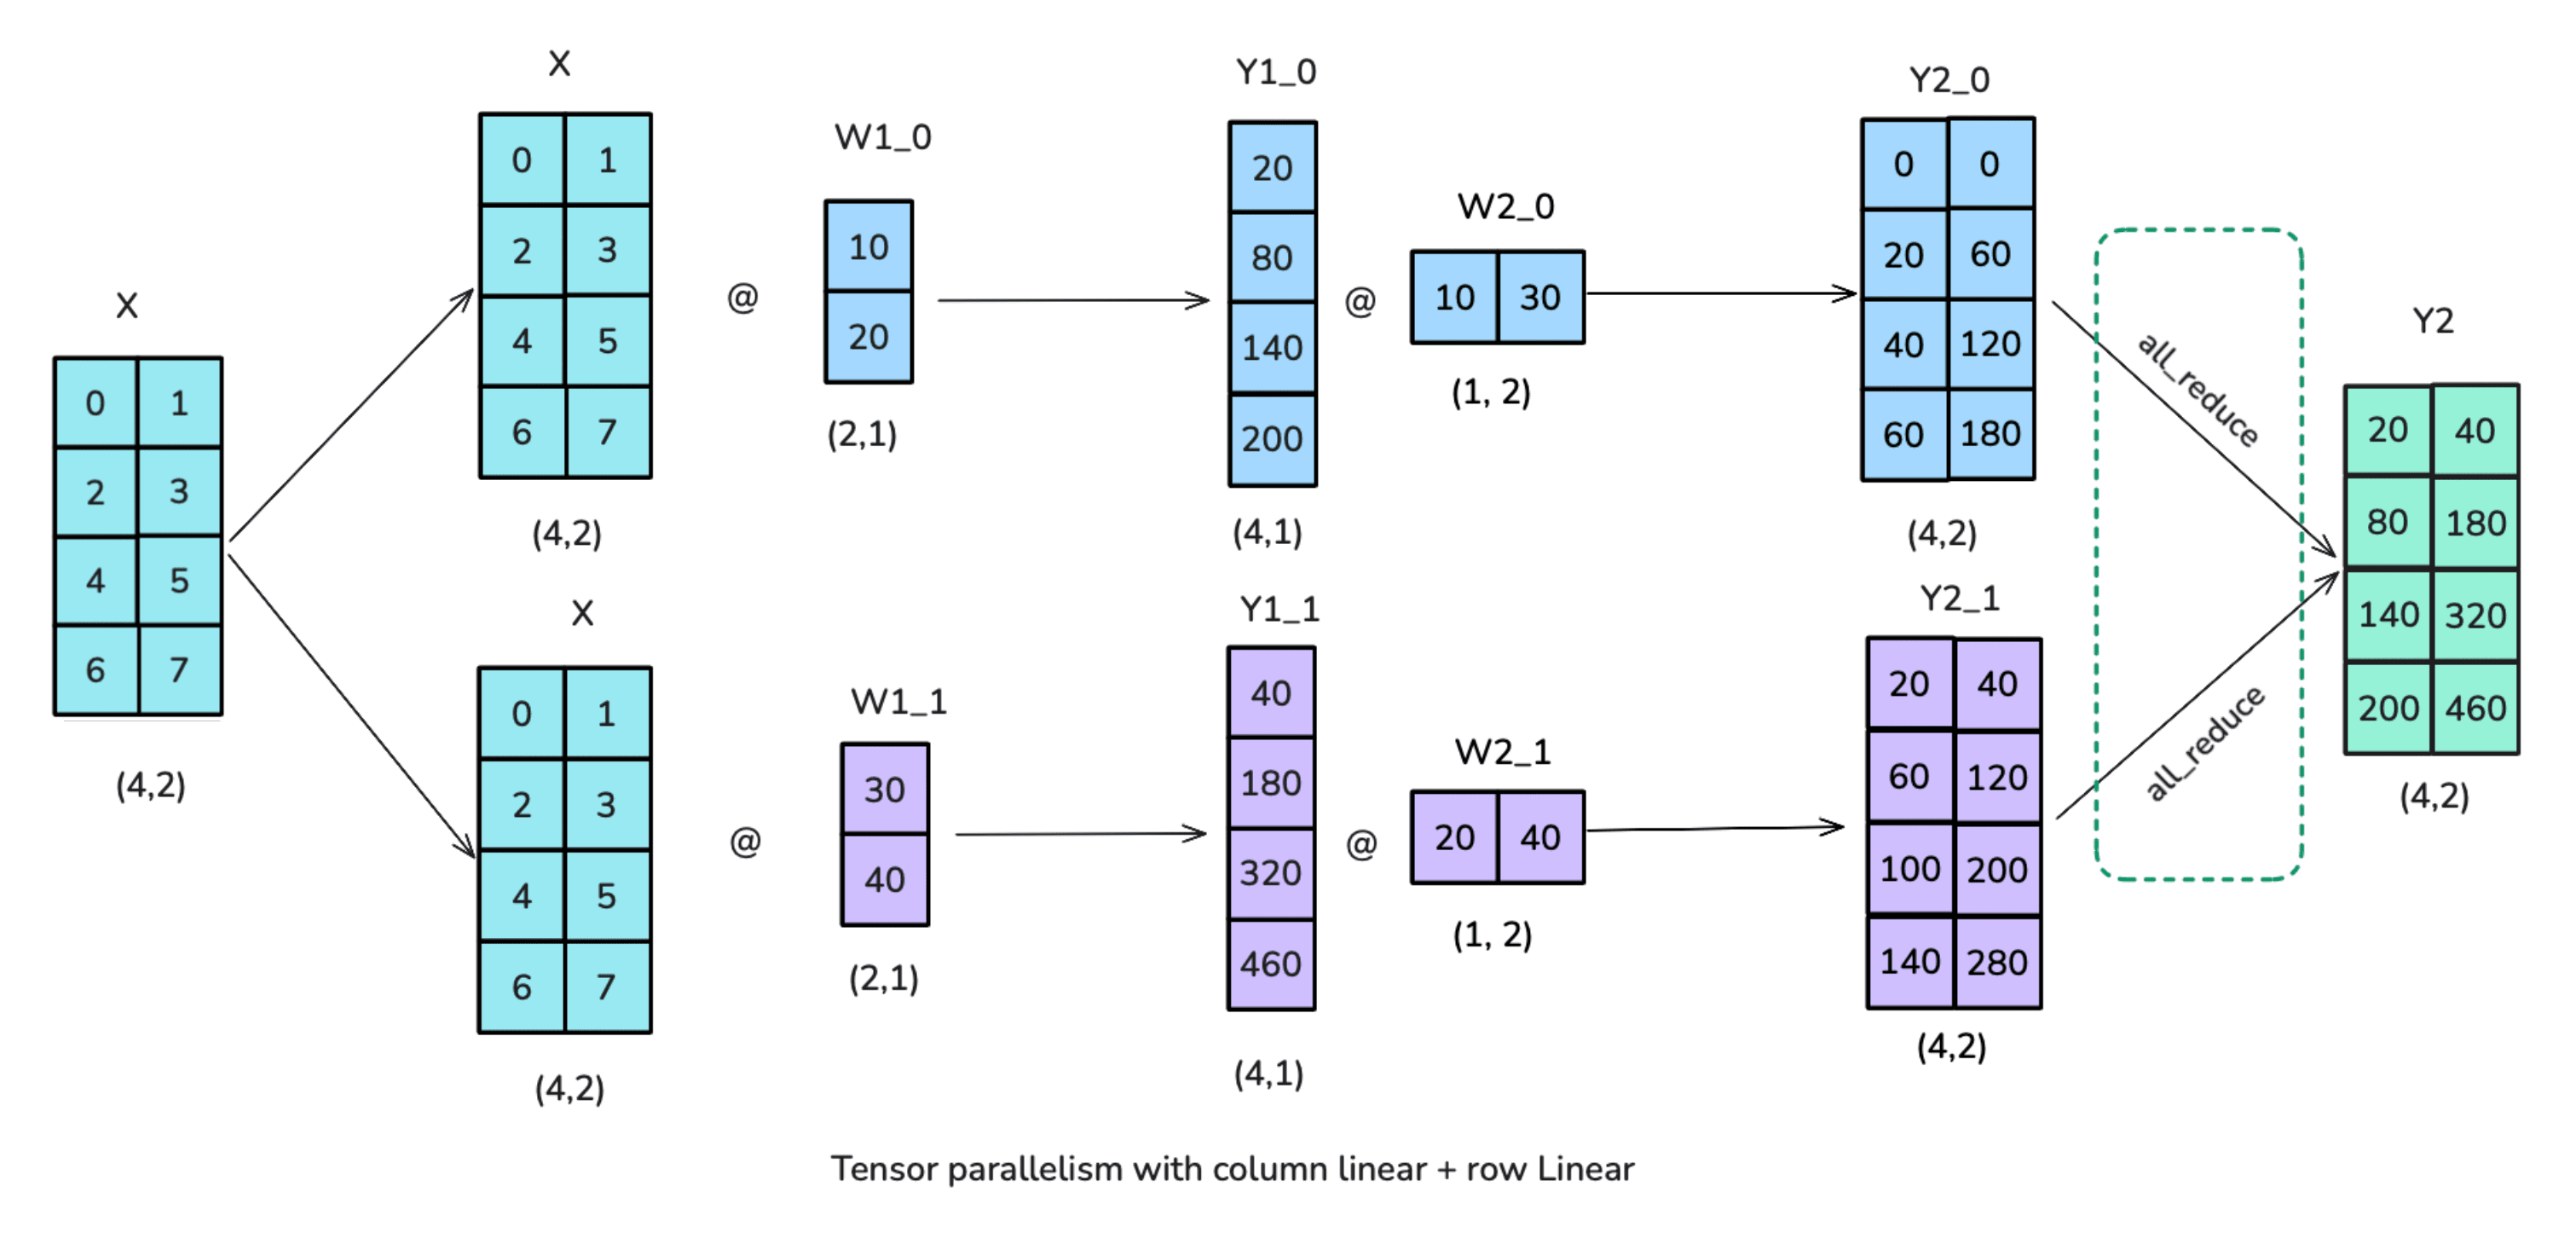
- 暂时不考虑激活函数,FFN 层可以简化为
- W_1 矩阵采用列切分的方式,但是中间不合并,直接算到底,可以省去一次 all-gather
- W_2 的矩阵采用列切分的方式,因为输入的 本身已经按照列切分了,因此 按照行切分,最后来一次 All-Reduce
Tensor Parallel for Attention Layer
标准 Multi-Head Attention 中:, 其中 .
如果使用 2-way TP,我们沿着权重矩阵的列方向切分:
本质上就是按照注意力头进行列切分。因此,Attention Score 的计算本质是一个列切分的 TP
假设是 2-way TP,则每一个 GPU 产生的 , 合并起来的 此时,需要做一次 output projection,B 矩阵的 size 是 , 因此可以再做一次 行切分,进行并行计算,最后做一次 All-reduce。
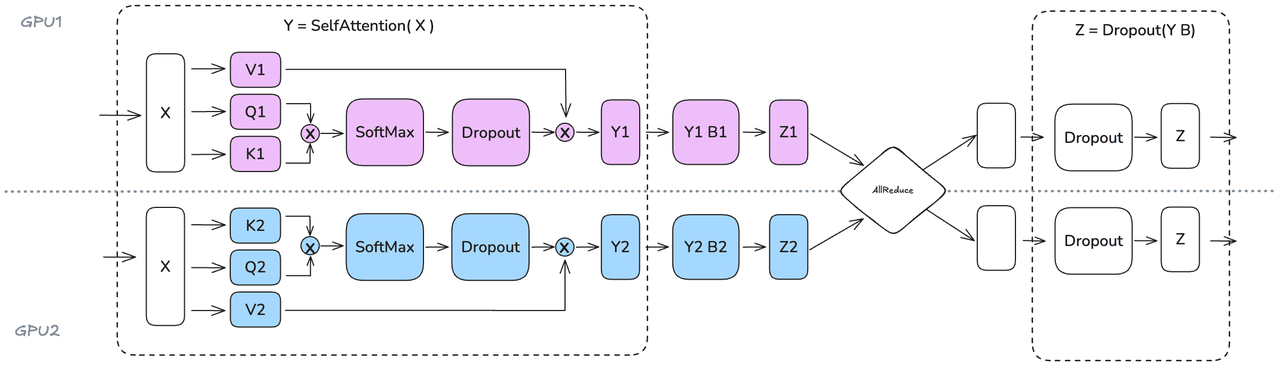
TP 可以降低每张 GPU 上计算内容的显存占用(因为大矩阵被切分了),可以提升 Batch-Size,但是对应的代价就是通信占用额外的开销,例如上文例子,一层 Transformer Block 就会到来 2 次 All-Reduce 的开销。
Sequence Parallel
TP 之后还剩一块内存大头:LayerNorm 和 dropout 这类操作需要完整的隐藏维 才能计算(比如 LayerNorm 要跨隐藏维求均值、方差):
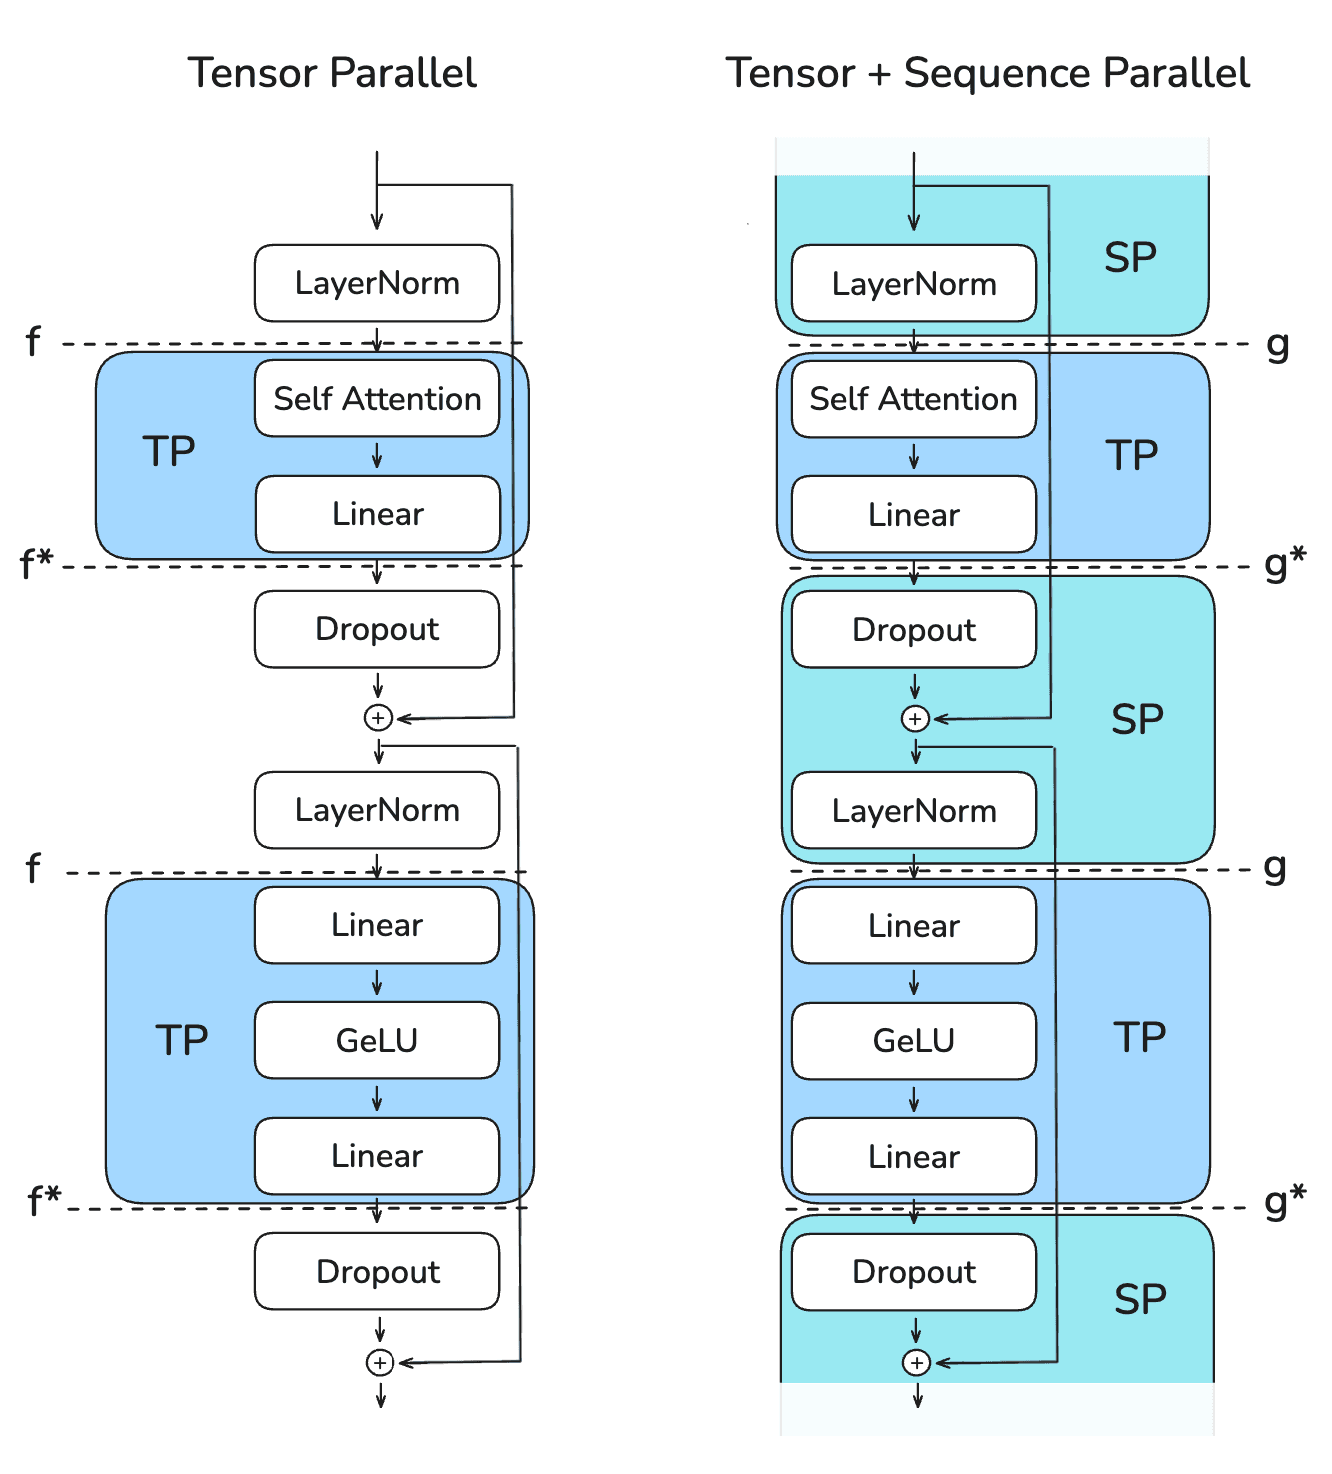
SP 的思路是把它们沿序列维切分,让每张卡只处理自己那段序列。于是前向过程在TP 区(矩阵乘,隐藏维被切)与 SP 区(LayerNorm / dropout,序列维被切)之间交替,靠一对对偶操作 f / g 切换:
- 进入 TP 区用 all-gather 把序列拼回全量
- 离开 TP 区用 reduce-scatter 再切回序列维
- TP 区内则用 all-reduce 保证正确性。
举例子,比如在 Attention 的 TP 区,最终得到一个 的输出矩阵需要做 LayerNorm
此时,进入 SP 区,不在按照 的切分方式(这是 TP 的切割维度),而是切分成 的两个矩阵,分别对每一个 layer 做 norm,然后通过 all-gather 拼接回去。
Context Parallel
SP 区解决了在 TP 区域无法覆盖的计算阶段,如何减少单卡的显存占用。但是在 TP 区内部,如果 足够的大,也会导致 CUDA OOM。CP 把输入沿序列维切分到多卡,并作用于整个模型。MLP、LayerNorm 这类逐 token 独立运算切分后不受影响;但 attention 需要每个 token 访问全序列的 K/V,必须跨卡通信。
例如,在四张卡做 CP(为了简单起见,在这个情景下我们不再做 TP),每张卡上的输入矩阵为 ,在做完 Projection 之后,需要形成一个 的超大下三角 attention 矩阵,其中不同区域的 q,k 向量需要进行点积计算。
- Ring Attention 使用最朴素的 GPU Ring 通信,通过轮转发送自己的 KV 矩阵给其他的 GPU,生成对应的 Attention Score 矩阵
- 各卡先异步把自己的 K/V 发给下一张卡(环形),同时用手里已有的 K/V 计算部分注意力,下一轮数据到达前刚好算完——计算与通信重叠,把“等数据”的时间藏进“算注意力”的时间里。
- 朴素的 Ring Attention 存在问题,如果 token 是按照顺序分配的,那么最后一张 GPU 的计算负载会远大于第一张 GPU 的计算负载(因为 token 长度差异),因此 Zig-Zag Attention 通过重排 token 分配顺序,让每张卡手里都混合有“靠前的 token”和“靠后的 token”,把计算量拉平。
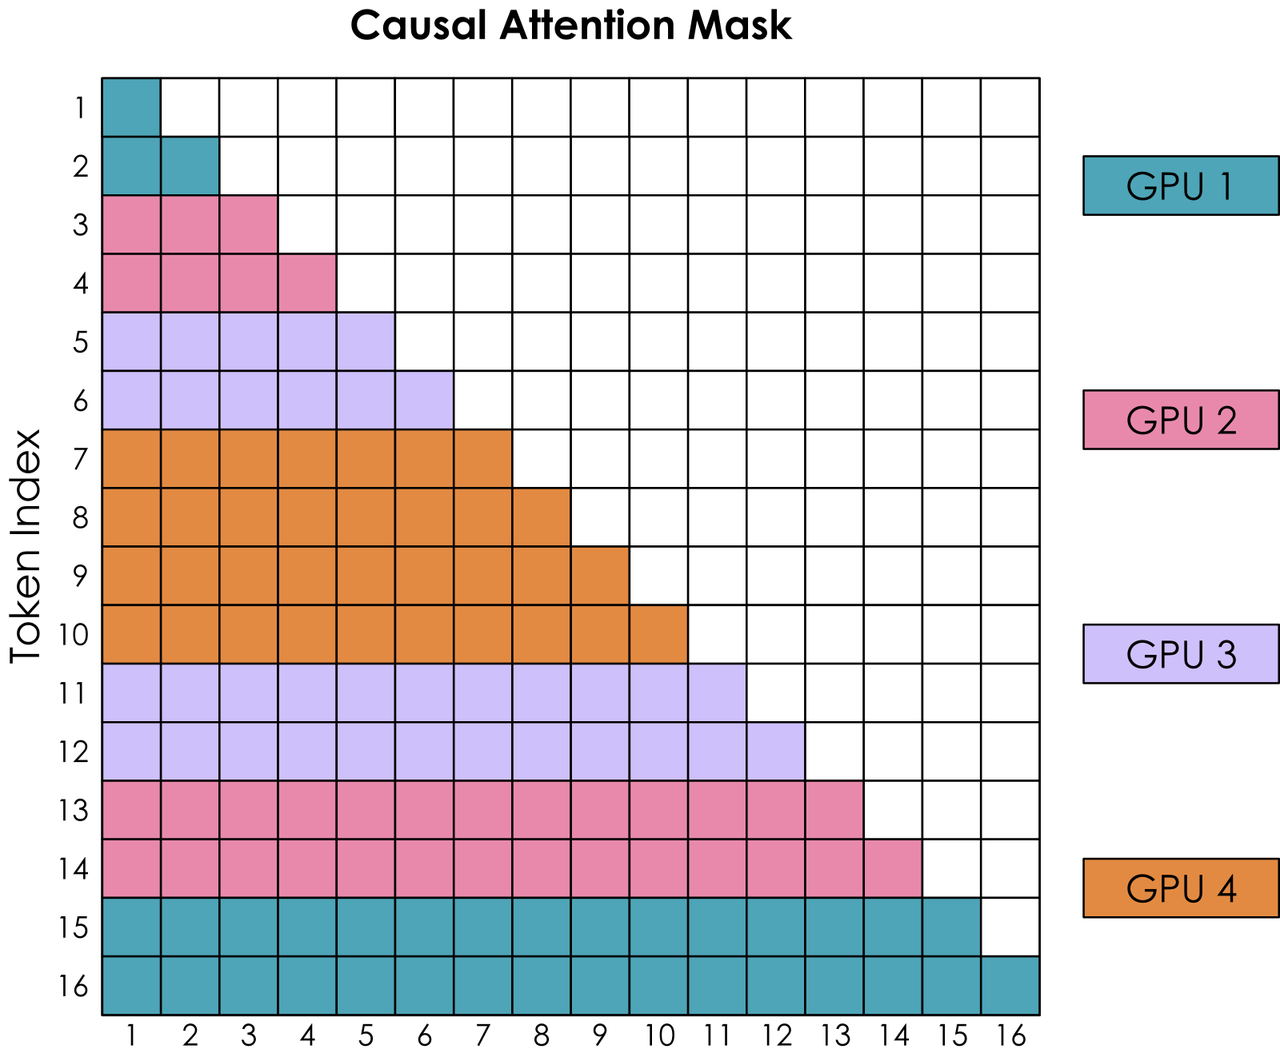
Pipeline Parallel
Pipeline Parallel 不再进行矩阵切割,而是从流水线的角度进行优化。可以把 个 Transformer Block 看作不同的串行流水线阶段,每一张 GPU 负责 个 block 的计算和梯度更新。
- PP 不会节省单张 GPU 的激活值,但是可以提升模型训练和前向计算的效率(相比于 SFDP,具有更短的通信时间)
- PP 最严重的问题是流水线气泡。启动和收尾阶段大量 GPU 空等。把 batch 切成 m 个微批可显著缩小气泡。因此可以采用 Mini-Batch (例如下图就是 1F1B) 的形式,可以不断压缩 GPU 的气泡时间。
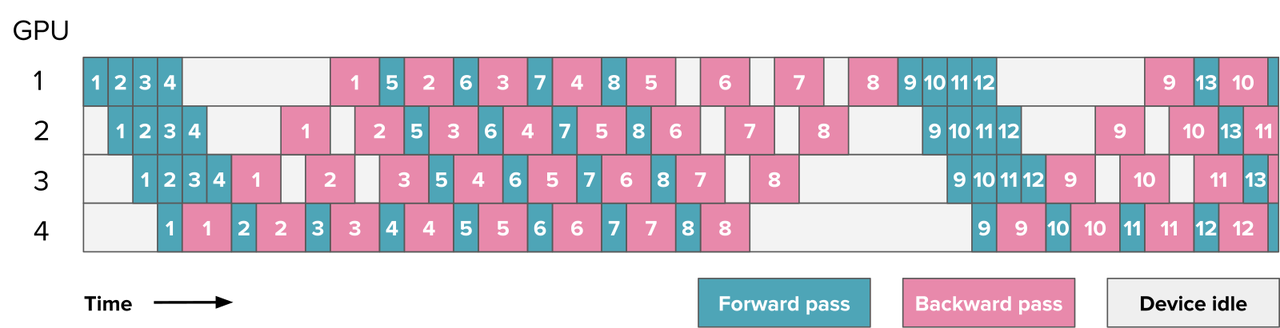
- 在 1F1B 的基础上,还可以进一步减少气泡发生率,例如在等待中的 forward 过程可以发送到空闲 GPU 上进行计算,但是会引入额外的通信开销。
Expert Parallel
MoE 把每层的单个 FFN 换成多个并行的专家 FFN,由一个 Router 按概率把每个 token 分给少数几个专家(下图)。由于各专家完全独立,很自然地可以把不同专家放到不同卡上。这就是专家并行(EP):token 通过 All-to-All 通信被路由到对应专家所在的卡,算完再送回。
Expert-Parallel 因为只对 FFN 层做并行,对其他层仍然是重复计算,因此常常和 DP, TP 等等技术进行结合。(EP 甚至也可以理解为一种根据 router 实现的,对 FFN 层施加的 Tensor parallel)
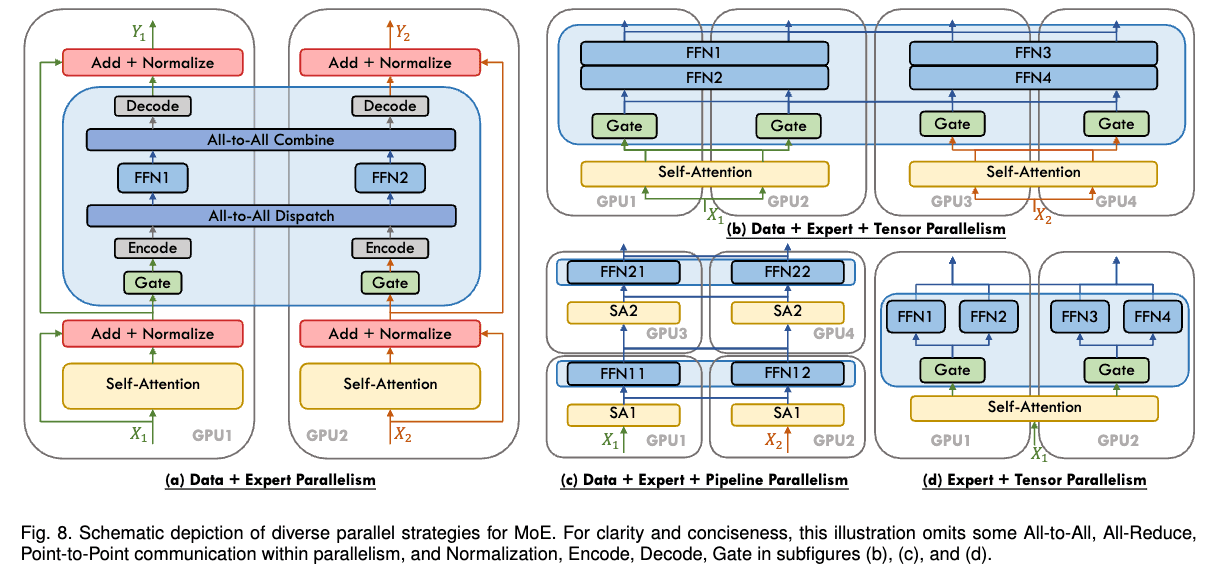
Mixed Precision Training
| 格式 | 位宽 | 位布局(符号/指数/尾数) | 最大有限值 | 相对精度(约) | 训练中的典型角色 |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ≈3.4e38 | 1.2e-7 | 主权重、优化器状态、GEMM 累加器 |
| FP16 | 16 | 1 / 5 / 10 | 65504 | 1e-3 | 早期混合精度训练的前向/反向(需 loss scaling) |
| BF16 | 16 | 1 / 8 / 7 | ≈3.4e38 | 8e-3 | 当前预训练主流的计算格式(无需 loss scaling) |
| FP8 E4M3 | 8 | 1 / 4 / 3 | 448 | 1.2e-1 | 偏精度;DeepSeek-V3 全张量统一采用 |
| FP8 E5M2 | 8 | 1 / 5 / 2 | 57344 | 2.5e-1 | 偏动态范围;业界默认用于反向梯度 |
| MXFP4 | 4(+共享缩放) | 1 / 2 / 1 + 每 32 元素一个 E8M0 | 6(缩放前) | 5e-1 | 下一代格式:推理压缩为主,训练探索中 |