在上一讲,我们从最基本的 RL 理论出发,一路推导到了最经典的 RL 理论算法: PPO
在 PPO 基础上,一系列经典的强化学习算法被应用到了 LLM 后训练中,我们会从 timeline 出发,了解GRPO 时代和前 GRPO 时代中,那些经典的 LLM RL 算法。
Timeline# 我们有必要梳理一下在 LLM 中经典 RL 算法被提出的时间线:
PPO for LLMs# Vanilla PPO# 在 LLM 的场景下,我们首先来看如何把 vanilla-ppo 算法迁移到 LLM 建模中去:
LLM 本身的参数作为 Policy θ \theta θ 暂时不考虑 Next-Token-Prediction 的过程,given prompt x x x y y y R ( x , y ) R(x, y) R ( x , y )
因此,目标函数可以写成一个更简单的形式:
J ( θ ) = E y ∼ π θ ( ⋅ ∣ x ) [ R ( x , y ) ]
J(\theta)=\mathbb E_{y\sim\pi_\theta(\cdot\mid x)}[R(x,y)]
J ( θ ) = E y ∼ π θ ( ⋅ ∣ x ) [ R ( x , y )] 在原始的 Policy Gradient 中,形式是:
∇ θ J ( θ ) = E τ [ ∑ t = 0 T − 1 γ t ∇ θ log π θ ( a t ∣ s t ) A π θ ( s t , a t ) ]
\nabla_\theta J(\theta) = \mathbb E_\tau\left[ \sum_{t=0}^{T-1} \gamma^t \nabla_\theta\log\pi_\theta(a_t\mid s_t) A^{\pi_\theta}(s_t,a_t) \right]
∇ θ J ( θ ) = E τ [ t = 0 ∑ T − 1 γ t ∇ θ log π θ ( a t ∣ s t ) A π θ ( s t , a t ) ] 但是在这里,对轨迹 τ \tau τ y y y ∑ 0 T − 1 \sum_{0}^{T-1} ∑ 0 T − 1
∇ θ J ( θ ) = E y ∼ π θ ( ⋅ ∣ x ) [ ∇ θ log π θ ( y ∣ x ) A π θ ( x , y ) ]
\nabla_\theta J(\theta) = \mathbb{E}_{y\sim\pi_\theta(\cdot\mid x)} \left[ \nabla_\theta\log\pi_\theta(y\mid x) A^{\pi_\theta}(x,y) \right]
∇ θ J ( θ ) = E y ∼ π θ ( ⋅ ∣ x ) [ ∇ θ log π θ ( y ∣ x ) A π θ ( x , y ) ] 其中: A π θ ( x , y ) = R ( x , y ) − E y ′ ∼ π θ ( ⋅ ∣ x ) [ R ( x , y ′ ) ] A^{\pi_\theta}(x,y) =R(x,y)- \mathbb E_{y'\sim\pi_\theta(\cdot\mid x)}[R(x,y')] A π θ ( x , y ) = R ( x , y ) − E y ′ ∼ π θ ( ⋅ ∣ x ) [ R ( x , y ′ )]
RLVR-PPO/RLHF-PPO# 在 RLHF-PPO 中提出了一个核心改进,即引入了 Reference Model 和 Reward Model:
Policy Model: 被训练的核心模型,输入仍然是 π θ ( a ∣ s ) \pi_{\theta}(a \mid s) π θ ( a ∣ s ) s s s Value Model: 在 PPO 中训练的 Value Network Reward Model: 冻结 ,针对模型输出 response 进行打分,类似于之前 rl 中的 r r r 在 RLHF 场景下,奖励信号是根据 reward-model(使用偏好数据对进行训练)给出的 在 RLVR 场景下,奖励信号直接根据环境给出 Reference Model : 冻结 ,主要避免过度微调,设计的 KL 散度 reward我们需要额外加一个 KL 惩罚:
J R L H F ( θ ) = E q , o ∼ π θ [ r R M ( q , o ) ] − β E q [ D K L ( π θ ( ⋅ ∣ q ) ∥ π r e f ( ⋅ ∣ q ) ) ]
J_{\mathrm{RLHF}}(\theta) = \mathbb E_{q,o\sim\pi_\theta} \left[ r_{\mathrm{RM}}(q,o) \right] - \beta \mathbb E_q\left[ D_{\mathrm{KL}} \left( \pi_\theta(\cdot\mid q) \Vert \pi_{\mathrm{ref}}(\cdot\mid q) \right) \right]
J RLHF ( θ ) = E q , o ∼ π θ [ r RM ( q , o ) ] − β E q [ D KL ( π θ ( ⋅ ∣ q ) ∥ π ref ( ⋅ ∣ q ) ) ] 在我们之前的推导中,我们的数学期望内部是 R ( τ ) R(\tau) R ( τ ) θ \theta θ θ \theta θ
将期望展开:
J ( θ ) = ∑ y π θ ( y ∣ x ) [ r ( x , y ) − β log π θ ( y ∣ x ) π r e f ( y ∣ x ) ]
J(\theta) = \sum_y\pi_\theta(y\mid x) \left[ r(x,y)-\beta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} \right]
J ( θ ) = y ∑ π θ ( y ∣ x ) [ r ( x , y ) − β log π ref ( y ∣ x ) π θ ( y ∣ x ) ] 现在对 θ \theta θ
∇ θ J = ∑ y ∇ θ π θ ( y ∣ x ) [ r ( x , y ) − β log π θ ( y ∣ x ) π r e f ( y ∣ x ) ] ⏟ 第一项:Policy Probability 的梯度 − β ∑ y π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) π r e f ( y ∣ x ) ⏟ 第二项:KL Reward 自身的梯度
\begin{aligned} \nabla_\theta J ={}& \underbrace{ \sum_y\nabla_\theta\pi_\theta(y\mid x) \left[ r(x,y)-\beta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} \right] }_{\text{第一项:Policy Probability 的梯度}}\\[8pt] &- \underbrace{ \beta\sum_y\pi_\theta(y\mid x) \nabla_\theta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} }_{\text{第二项:KL Reward 自身的梯度}} \end{aligned}
∇ θ J = 第一项: Policy Probability 的梯度 y ∑ ∇ θ π θ ( y ∣ x ) [ r ( x , y ) − β log π ref ( y ∣ x ) π θ ( y ∣ x ) ] − 第二项: KL Reward 自身的梯度 β y ∑ π θ ( y ∣ x ) ∇ θ log π ref ( y ∣ x ) π θ ( y ∣ x ) 下面,我们证明第二项是 0,我们基于梯度化简第二项:
∑ y π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) π r e f ( y ∣ x ) = ∑ y π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) = ∑ y ∇ θ π θ ( y ∣ x )
\sum_y\pi_\theta(y\mid x) \nabla_\theta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} = \sum_y\pi_\theta(y\mid x) \nabla_\theta\log{\pi_\theta(y\mid x)} = \sum_y \nabla_\theta\pi_\theta(y\mid x)
y ∑ π θ ( y ∣ x ) ∇ θ log π ref ( y ∣ x ) π θ ( y ∣ x ) = y ∑ π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) = y ∑ ∇ θ π θ ( y ∣ x ) 我们惊喜的发现,我们可以使用第一讲推导的零均值性质:
∑ y ∇ θ π θ ( y ∣ x ) = ∇ θ ∑ y π θ ( y ∣ x ) = ∇ θ 1 = 0
\sum_y \nabla_\theta\pi_\theta(y\mid x) = \nabla_\theta\sum_y \pi_\theta(y\mid x) = \nabla_\theta 1 = 0
y ∑ ∇ θ π θ ( y ∣ x ) = ∇ θ y ∑ π θ ( y ∣ x ) = ∇ θ 1 = 0 因此,我们可以推导,哪怕在加上 KL 散度后,我们的 reward 可以被写为:
∇ θ J = ∑ y ∇ θ π θ ( y ∣ x ) [ r ( x , y ) − β log π θ ( y ∣ x ) π r e f ( y ∣ x ) ] = ∑ y π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) [ r ( x , y ) − β log π θ ( y ∣ x ) π r e f ( y ∣ x ) ]
\nabla_\theta J = \sum_y\nabla_\theta\pi_\theta(y\mid x) \left[ r(x,y)-\beta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} \right] = \sum_y \pi_\theta(y\mid x)\nabla_\theta\log\pi_\theta(y\mid x) \left[ r(x,y)-\beta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} \right]
∇ θ J = y ∑ ∇ θ π θ ( y ∣ x ) [ r ( x , y ) − β log π ref ( y ∣ x ) π θ ( y ∣ x ) ] = y ∑ π θ ( y ∣ x ) ∇ θ log π θ ( y ∣ x ) [ r ( x , y ) − β log π ref ( y ∣ x ) π θ ( y ∣ x ) ] 此时,我们可以认为 r ′ ( x , y ) = r ( x , y ) − β log π θ ( y ∣ x ) π r e f ( y ∣ x ) r'(x,y) = r(x,y)-\beta\log\frac{\pi_\theta(y\mid x)} {\pi_{\mathrm{ref}}(y\mid x)} r ′ ( x , y ) = r ( x , y ) − β log π ref ( y ∣ x ) π θ ( y ∣ x )
注意,但是这个不是一个普适的性质,因为我们必须得保证第二项 (KL Reward 自身期望的梯度为 0 )
Token Level or Sequence Level?# 在上文无论是 Vanilla-PPO 还是 RLHF-PPO,都是在 sequence-level 上做的,也就是说,我们假想模型 π θ \pi_{\theta} π θ x x x y y y
整个 Response 的 KL Divergence,可以分解成每一个 Token 的 Conditional KL Divergence。
具体来说,Next-token-prediction 可以通过概率的方式建模出来:
log π θ ( y ∣ x ) = ∑ t = 1 ∣ y ∣ log π θ ( y t ∣ x , y < t )
\log\pi_\theta(y\mid x) =\sum_{t=1}^{|y|} \log\pi_\theta(y_t\mid x,y_{<t})
log π θ ( y ∣ x ) = t = 1 ∑ ∣ y ∣ log π θ ( y t ∣ x , y < t ) 具体到 KL 散度,可以被分解为:
log π θ ( y ∣ x ) π r e f ( y ∣ x ) = log ∏ t = 1 T π θ ( y t ∣ s t ) ∏ t = 1 T π r e f ( y t ∣ s t ) = ∑ t = 1 T log π θ ( y t ∣ s t ) π r e f ( y t ∣ s t )
\begin{aligned} \log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)} &=\log\frac{\prod_{t=1}^T\pi_\theta(y_t\mid s_t)} {\prod_{t=1}^T\pi_{\mathrm{ref}}(y_t\mid s_t)} \\ &=\sum_{t=1}^T\log\frac{\pi_\theta(y_t\mid s_t)} {\pi_{\mathrm{ref}}(y_t\mid s_t)} \end{aligned}
log π ref ( y ∣ x ) π θ ( y ∣ x ) = log ∏ t = 1 T π ref ( y t ∣ s t ) ∏ t = 1 T π θ ( y t ∣ s t ) = t = 1 ∑ T log π ref ( y t ∣ s t ) π θ ( y t ∣ s t ) 我们可以定义每个 token 采样的 log-ratio: k t = log π θ ( y t ∣ s t ) − log π r e f ( y t ∣ s t ) k_t=\log\pi_\theta(y_t\mid s_t) -\log\pi_{\mathrm{ref}}(y_t\mid s_t) k t = log π θ ( y t ∣ s t ) − log π ref ( y t ∣ s t )
D K L ( π θ ∥ π r e f ) = E y ∼ π θ [ ∑ t = 1 T k t ]
\boxed{ D_{\mathrm{KL}}(\pi_\theta\Vert\pi_{\mathrm{ref}}) = \mathbb E_{y\sim\pi_\theta} \left[\sum_{t=1}^T k_t\right] }
D KL ( π θ ∥ π ref ) = E y ∼ π θ [ t = 1 ∑ T k t ] 因为模型只会在最后的 sequence-level 给出一个 reward,因此我们需要手动构造 token-level 的 reward,在 RLHF-PPO 中,token-level 的 reward 是这样给出的:
r ~ t = { − β k t , t < T R ( x , y ) − β k t , t = T
\tilde r_t= \begin{cases} -\beta k_t,&t<T\\[4pt] R(x,y)-\beta k_t,&t=T \end{cases}
r ~ t = { − β k t , R ( x , y ) − β k t , t < T t = T 也就是说:
中间 Token:只获得 KL Penalty。 最后一个 Token:获得 KL Penalty 和最终任务 Reward。 具体代码的实现细节可以查看: https://github.com/huggingface/blog/blob/main/the_n_implementation_details_of_rlhf_with_ppo.md
这样的 reward 定义可以保证,累和后的 reward 等于 R ( x , y ) R(x,y) R ( x , y ) ( s 0 = x , a 0 = y 1 , r 0 , s 1 = ( x , y 1 ) , a 2 = y 2 , … ) (s_0 = x, a_0 = y_1, r_0, s_1 = (x, y_1), a_2 = y_2, \dots) ( s 0 = x , a 0 = y 1 , r 0 , s 1 = ( x , y 1 ) , a 2 = y 2 , … )
如果不是最后一个 token,如何获得奖励? 回忆 PPO 中,我们的 A ( s , a ) A(s,a) A ( s , a )
因此,最终在 token-level 上,RLHF-PPO 的 objective 是:
L C L I P ( θ ) = E y ∼ π o l d [ 1 T ∑ t = 1 T min ( ρ t ( θ ) A ^ t , clip ( ρ t ( θ ) , 1 − ϵ , 1 + ϵ ) A ^ t ) ]
L^{\mathrm{CLIP}}(\theta)= \mathbb E_{y\sim\pi_{\mathrm{old}}} \left[ \frac{1}{T}\sum_{t=1}^T \min\left( \rho_t(\theta)\hat A_t,\, \operatorname{clip}(\rho_t(\theta),1-\epsilon,1+\epsilon)\hat A_t \right) \right]
L CLIP ( θ ) = E y ∼ π old [ T 1 t = 1 ∑ T min ( ρ t ( θ ) A ^ t , clip ( ρ t ( θ ) , 1 − ϵ , 1 + ϵ ) A ^ t ) ] Direct Preference Optimization (DPO)# TL;DR# 在 22 年提出的 RLHF-PPO 中,模型首先根据偏好数据对学习出一个 Reward-Model 进行打分,然后进行 PPO Update。但是,reward model 给出的监督信号往往是不准确的,同时会存在 reward-hacking 等问题。
因此,DPO 希望 LLM 可以直接在偏好数据集上学习,而不再需要“绕个路”,依赖 reward model 提供的奖励信号。
在 RLVR 上,这个问题其实并不存在,因为环境会给出最准确的奖励信号,但是在其他 hard-to-verify 的问题 && 指令偏好对齐的场景下,reward 信号的问题显的极为重要。
因此,DPO 和 PPO 在训练目标和训练方式上存在很大的差异:
DPO 算法是离线 off-policy 的,也就是训练中不需要引入任何的 rollout 过程 DPO 算法需要的数据是静态的离线偏好数据对 (这也是 RLHF 的一种格式之一。) DPO 的亮点就在于它可以绕过 reward model,直接在静态数据上产生梯度,进行训练。
Removing the RL from RLHF# Recall we want to maximize the following objective in RLHF
E y ^ ∼ p θ R L ( y ^ ∣ x ) [ R M ϕ ( x , y ^ ) − β log ( p θ R L ( y ^ ∣ x ) p P T ( y ^ ∣ x ) ) ] \mathbb{E}_{\hat{y} \sim p_{\theta}^{RL}(\hat{y}|x)}[RM_{\phi}(x, \hat{y}) - \beta \log \left(\frac{p_{\theta}^{RL}(\hat{y}|x)}{p^{PT}(\hat{y}|x)}\right)] E y ^ ∼ p θ R L ( y ^ ∣ x ) [ R M ϕ ( x , y ^ ) − β log ( p P T ( y ^ ∣ x ) p θ R L ( y ^ ∣ x ) ) ] p ∗ ( y ^ ∣ x ) = 1 Z ( x ) p P T ( y ^ ∣ x ) exp ( 1 β R M ( x , y ^ ) ) p^{*}(\hat{y}|x) = \frac{1}{Z(x)} p^{PT}(\hat{y}|x) \exp(\frac{1}{\beta} RM(x, \hat{y})) p ∗ ( y ^ ∣ x ) = Z ( x ) 1 p P T ( y ^ ∣ x ) exp ( β 1 R M ( x , y ^ )) Z ( x ) Z(x) Z ( x )
Rearrange this via a log transformation
R M ( x , y ^ ) = β ( log p ∗ ( y ^ ∣ x ) − log p P T ( y ^ ∣ x ) ) + β log Z ( x ) = β log p ∗ ( y ^ ∣ x ) p P T ( y ^ ∣ x ) + β log Z ( x ) RM(x, \hat{y}) = \beta \left(\log p^{*}(\hat{y}|x) - \log p^{PT}(\hat{y}|x)\right) + \beta \log Z(x) = \beta \log \frac{p^{*}(\hat{y}|x)}{p^{PT}(\hat{y}|x)} + \beta \log Z(x) R M ( x , y ^ ) = β ( log p ∗ ( y ^ ∣ x ) − log p P T ( y ^ ∣ x ) ) + β log Z ( x ) = β log p P T ( y ^ ∣ x ) p ∗ ( y ^ ∣ x ) + β log Z ( x ) This holds true for any arbitrary LMs, thus R M θ ( x , y ^ ) = β log p θ R L ( y ^ ∣ x ) p P T ( y ^ ∣ x ) + β log Z ( x ) RM_{\theta}(x, \hat{y}) = \beta \log \frac{p_{\theta}^{RL}(\hat{y}|x)}{p^{PT}(\hat{y}|x)} + \beta \log Z(x) R M θ ( x , y ^ ) = β log p P T ( y ^ ∣ x ) p θ R L ( y ^ ∣ x ) + β log Z ( x ) What does that tells us? The ideal RM model can be computed if we get the optimized policy p θ RL p_\theta^{\text{RL}} p θ RL
Algorithm# Hence, we can derive the reward model directly:
R M ϕ ( x , y ^ ) ∝ log p θ R L ( y ^ ∣ x ) p P T ( y ^ ∣ x ) RM_\phi(x, \hat{y}) \propto \log \frac{p_{\theta}^{RL}(\hat{y}|x)}{p^{PT}(\hat{y}|x)} R M ϕ ( x , y ^ ) ∝ log p P T ( y ^ ∣ x ) p θ R L ( y ^ ∣ x ) We just ignore Z ( x ) Z(x) Z ( x )
Defining Direct Preference Optimization :
Previous: Highly relied on trained reward model (bottleneck)
L R L ( θ ) = − E y ^ ∼ p θ R L ( y ^ ∣ x ) [ R M ϕ ( x , y ^ ) − β log ( p θ R L ( y ^ ∣ x ) p P T ( y ^ ∣ x ) ) ] L_{RL}(\theta) = -\mathbb{E}_{\hat{y} \sim p_{\theta}^{RL}(\hat{y}|x)}[RM_{\phi}(x, \hat{y}) - \beta \log \left(\frac{p_{\theta}^{RL}(\hat{y}|x)}{p^{PT}(\hat{y}|x)}\right)] L R L ( θ ) = − E y ^ ∼ p θ R L ( y ^ ∣ x ) [ R M ϕ ( x , y ^ ) − β log ( p P T ( y ^ ∣ x ) p θ R L ( y ^ ∣ x ) ) ] Now: Using DPO into a loss function, learning directly from p P T p^{PT} p P T p θ R L p_{\theta}^{RL} p θ R L
L D P O ( θ ) = − E ( x , y W , y l ) ∼ D log σ ( β log p θ R L ( y w ∣ x ) p P T ( y w ∣ x ) − β log p θ R L ( y l ∣ x ) p P T ( y l ∣ x ) ) L_{DPO}(\theta) = -\mathbb{E}_{(x,y_W,y_l)\sim D} \log\sigma\left(\beta \log\frac{p_{\theta}^{RL}(y_w|x)}{p^{PT}(y_w|x)} - \beta \log\frac{p_{\theta}^{RL}(y_l|x)}{p^{PT}(y_l|x)}\right) L D P O ( θ ) = − E ( x , y W , y l ) ∼ D log σ ( β log p P T ( y w ∣ x ) p θ R L ( y w ∣ x ) − β log p P T ( y l ∣ x ) p θ R L ( y l ∣ x ) )
L D P O ( θ ) = − E ( x , y W , y l ) ∼ D log σ ( β log p θ R L ( y w ∣ x ) p P T ( y l ∣ x ) p θ R L ( y l ∣ x ) p P T ( y w ∣ x ) ) L_{DPO}(\theta) = -\mathbb{E}_{(x,y_W,y_l)\sim D} \log\sigma\left(\beta \log\frac{p_{\theta}^{RL}(y_w|x) p^{PT}(y_l|x)}{p_{\theta}^{RL}(y_l|x) p^{PT}(y_w|x)}\right) L D P O ( θ ) = − E ( x , y W , y l ) ∼ D log σ ( β log p θ R L ( y l ∣ x ) p P T ( y w ∣ x ) p θ R L ( y w ∣ x ) p P T ( y l ∣ x ) ) Using the data directly (learn directly!)
GRPO for LLMs# Advantages Estimations# 在 RLHF 时代,后训练 RL 更关注的是偏好对齐,DPO 给出了在偏好数据集上进行训练的最优解。在 RLHF 时代过后,就是以 GRPO 为主导的 RLVR 时代 ,模型可以在可验证的环境 上进行 RL 训练,提升特定领域的能力。
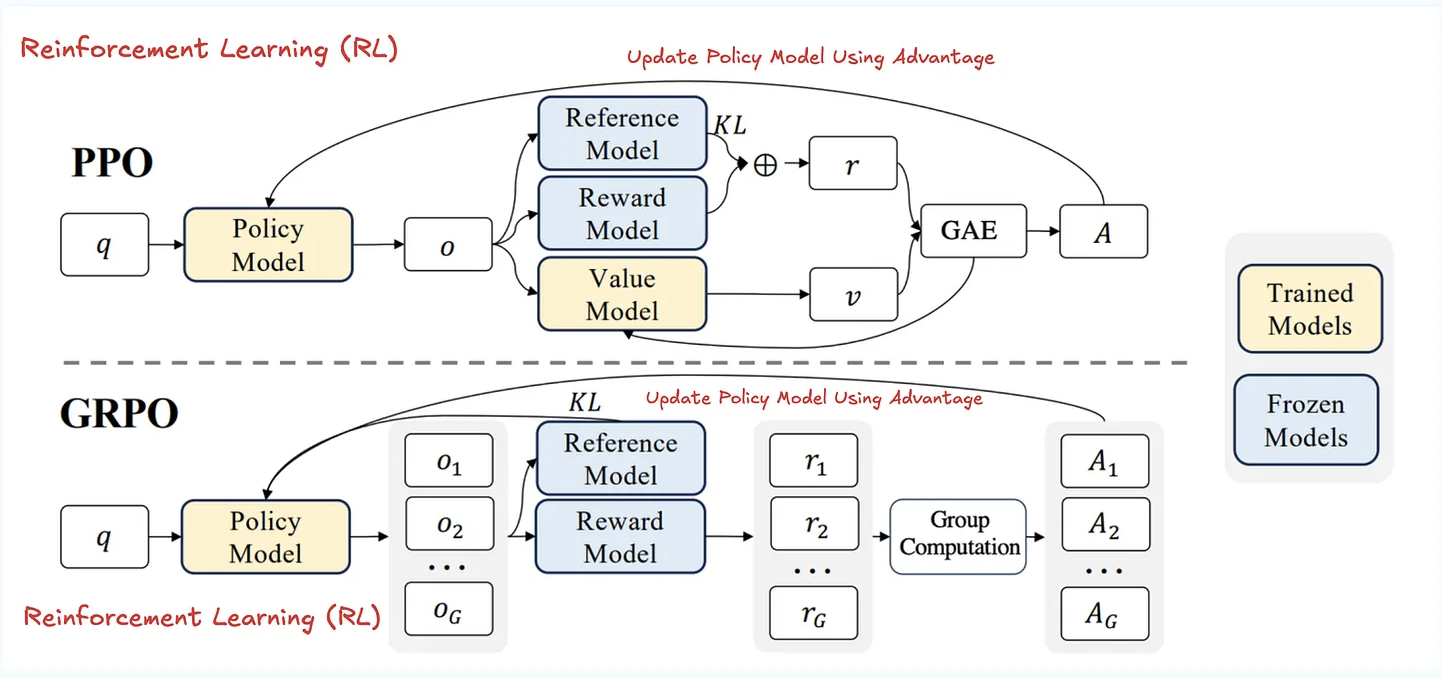
在 PPO 中,一共会涉及四个模型,管线异常复杂,工程复杂度高。因此,在 2023 年,RL 的研究重点是: 能否针对这个 Pipeline 进行简化?
PPO 如何估计 Advantages? 利用 GAE,根据 Value 网络进行:Define TD-Error: δ t = r t + γ V ϕ ( s t + 1 ) − V ϕ ( s t ) \delta_t=r_t+\gamma V_\phi(s_{t+1})-V_\phi(s_t) δ t = r t + γ V ϕ ( s t + 1 ) − V ϕ ( s t ) A ^ t P P O = ∑ l = 0 T − t ( γ λ ) l δ t + l \hat A_t^{\mathrm{PPO}} = \sum_{l=0}^{T-t}(\gamma\lambda)^l\delta_{t+l} A ^ t PPO = l = 0 ∑ T − t ( γ λ ) l δ t + l Advantage 中包含 sequence-level 的奖励加权,但是每个 token 给出的 reward 只是 KL 散度 DPO: 直接在静态偏好数据集上进行简化,省略 reward-model 的存在 Remax && GRPO : PPO 使用 Value Model 估计 Advantage;ReMax 和 GRPO 则尝试使用模型自身生成的其他 Responses 来构造 Baseline,从而不再需要训练 Value Model。 受到篇幅限制,我们在这里只重点展开 GRPO 给出的算法改进:
Group Sampling:对于同一个 Prompt x x x G G G y 1 , … , y G ∼ i i d π θ o l d ( ⋅ ∣ x ) y_1,\ldots,y_G \overset{\mathrm{iid}}{\sim} \pi_{\theta_{\mathrm{old}}}(\cdot\mid x) y 1 , … , y G ∼ iid π θ old ( ⋅ ∣ x ) GRPO 的关键改进在于: 不再依赖 Value-Model 进行 Value estimate,而是依赖统计量进行估计。 Define R i = R ( x , y i ) R_i=R(x,y_i) R i = R ( x , y i )
μ R = 1 G ∑ i = 1 G R i
\mu_R=\frac1G\sum_{i=1}^G R_i
μ R = G 1 i = 1 ∑ G R i 再计算 Group Standard Deviation:
σ R = 1 G ∑ i = 1 G ( R i − μ R ) 2
\sigma_R = \sqrt{\frac1G\sum_{i=1}^G(R_i-\mu_R)^2}
σ R = G 1 i = 1 ∑ G ( R i − μ R ) 2 最后得到:
A ^ i G R P O = R i − μ R σ R
\hat A_i^{\mathrm{GRPO}} = \frac{R_i-\mu_R}{\sigma_R}
A ^ i GRPO = σ R R i − μ R 在 token-level 的时候,一个 sequence 上生成的所有 token 都享有这个 advantages(因为 GRPO 不再利用 GAE 进行 Advantages 估计,因此需要保证每一个 token 都能拿到 sequence-level 的 advantages)
在原始 GRPO 的 Outcome Supervision 中,同一个 Response 的全部 Token 共享同一个 Advantage: (i 是 rollout 标记, t 是对应 token-index)
A ^ i , t = A ^ i G R P O
\hat A_{i,t}=\hat A_i^{\mathrm{GRPO}}
A ^ i , t = A ^ i GRPO 在原始的 Policy Gradient 中,形式是:
∇ θ J ( θ ) = E τ [ ∑ t = 0 T − 1 γ t ∇ θ log π θ ( y t ∣ s t ) A π θ ( s t , y t ) ]
\nabla_\theta J(\theta) = \mathbb E_\tau\left[ \sum_{t=0}^{T-1} \gamma^t \nabla_\theta\log\pi_\theta(y_t\mid s_t) A^{\pi_\theta}(s_t,y_t) \right]
∇ θ J ( θ ) = E τ [ t = 0 ∑ T − 1 γ t ∇ θ log π θ ( y t ∣ s t ) A π θ ( s t , y t ) ] 因此,在 GRPO 中,原始的 Policy Gradient 可以写成:
∇ θ J ≈ 1 G ∑ i = 1 G A ^ i ∑ t = 1 T i ∇ θ log π θ ( y i , t ∣ s i , t ) \nabla_\theta J \approx \frac1G\sum_{i=1}^G \hat A_i \sum_{t=1}^{T_i} \nabla_\theta\log\pi_\theta(y_{i,t}\mid s_{i,t})
∇ θ J ≈ G 1 i = 1 ∑ G A ^ i t = 1 ∑ T i ∇ θ log π θ ( y i , t ∣ s i , t ) 这里使用近似号,是因为 GRPO 的组内标准化 Advantage 并非严格无偏的真实 Advantage Estimator。
Vanilla-GRPO# 同样,我们继续加上 PPO-Clip 和 KL 散度约束,形成最终的 GRPO 原始版形式:
ρ i , t ( θ ) = π θ ( o i , t ∣ q , o i , < t ) π θ o l d ( o i , t ∣ q , o i , < t )
\rho_{i,t}(\theta) = \frac{\pi_\theta(o_{i,t}\mid q,o_{i,<t})} {\pi_{\theta_{\mathrm{old}}}(o_{i,t}\mid q,o_{i,<t})}
ρ i , t ( θ ) = π θ old ( o i , t ∣ q , o i , < t ) π θ ( o i , t ∣ q , o i , < t ) J G R P O c l i p ( θ ) = E q ∼ P ( Q ) { o i } i = 1 G ∼ π θ o l d ( ⋅ ∣ q ) [ 1 G ∑ i = 1 G 1 T i ∑ t = 1 T i min ( ρ i , t ( θ ) A ^ i , clip ( ρ i , t ( θ ) , 1 − ϵ , 1 + ϵ ) A ^ i ) ]
\begin{aligned} J_{\mathrm{GRPO}}^{\mathrm{clip}}(\theta) ={}& \operatorname*{\mathbb E}_{\substack{ q\sim P(Q)\\ \{o_i\}_{i=1}^{G}\sim\pi_{\theta_{\mathrm{old}}}(\cdot\mid q) }} \Bigg[ \frac1G\sum_{i=1}^G\frac1{T_i}\sum_{t=1}^{T_i}\\ &\min\Big( \rho_{i,t}(\theta)\hat A_i,\, \operatorname{clip}\left( \rho_{i,t}(\theta),1-\epsilon,1+\epsilon \right)\hat A_i \Big) \Bigg] \end{aligned}
J GRPO clip ( θ ) = q ∼ P ( Q ) { o i } i = 1 G ∼ π θ old ( ⋅ ∣ q ) E [ G 1 i = 1 ∑ G T i 1 t = 1 ∑ T i min ( ρ i , t ( θ ) A ^ i , clip ( ρ i , t ( θ ) , 1 − ϵ , 1 + ϵ ) A ^ i ) ] 原始 GRPO 将 Reference KL 作为单独的惩罚项,理论上的 KL Divergence 定义为:
D K L ( π θ ( ⋅ ∣ s ) ∥ π r e f ( ⋅ ∣ s ) ) = ∑ v ∈ V π θ ( v ∣ s ) log π θ ( v ∣ s ) π r e f ( v ∣ s )
D_{\mathrm{KL}}\left( \pi_\theta(\cdot\mid s) \Vert \pi_{\mathrm{ref}}(\cdot\mid s) \right) = \sum_{v\in\mathcal V} \pi_\theta(v\mid s) \log\frac{\pi_\theta(v\mid s)} {\pi_{\mathrm{ref}}(v\mid s)}
D KL ( π θ ( ⋅ ∣ s ) ∥ π ref ( ⋅ ∣ s ) ) = v ∈ V ∑ π θ ( v ∣ s ) log π ref ( v ∣ s ) π θ ( v ∣ s ) 其中 V \mathcal V V s = ( q , o i , < t ) s=(q,o_{i,<t}) s = ( q , o i , < t )
但原始 GRPO 并没有直接对整个 Vocabulary 计算 KL,而是使用一个基于采样 Token 的 KL Estimator:
D ^ K L , i , t ( θ ) = π r e f ( o i , t ∣ q , o i , < t ) π θ ( o i , t ∣ q , o i , < t ) − log π r e f ( o i , t ∣ q , o i , < t ) π θ ( o i , t ∣ q , o i , < t ) − 1
\begin{aligned} \widehat D_{\mathrm{KL},i,t}(\theta) ={}& \frac{\pi_{\mathrm{ref}}(o_{i,t}\mid q,o_{i,<t})} {\pi_\theta(o_{i,t}\mid q,o_{i,<t})}\\ &-\log \frac{\pi_{\mathrm{ref}}(o_{i,t}\mid q,o_{i,<t})} {\pi_\theta(o_{i,t}\mid q,o_{i,<t})} -1 \end{aligned}
D KL , i , t ( θ ) = π θ ( o i , t ∣ q , o i , < t ) π ref ( o i , t ∣ q , o i , < t ) − log π θ ( o i , t ∣ q , o i , < t ) π ref ( o i , t ∣ q , o i , < t ) − 1 这个形式有两个重要性质:
对任意采样 Token,估计值非负。 如果 Token 从当前 Policy π θ \pi_\theta π θ D K L ( π θ ∥ π r e f D_{\mathrm{KL}}(\pi_\theta\Vert\pi_{\mathrm{ref}} D KL ( π θ ∥ π ref 从数学意义上解释,就是在保证无偏性的同时,可以保证方差下降 定义 KL Regularization:
J G R P O K L ( θ ) = E q ∼ P ( Q ) { o i } i = 1 G ∼ π θ o l d ( ⋅ ∣ q ) [ 1 G ∑ i = 1 G 1 T i ∑ t = 1 T i D ^ K L , i , t ( θ ) ]
J_{\mathrm{GRPO}}^{\mathrm{KL}}(\theta) = \operatorname*{\mathbb E}_{\substack{ q\sim P(Q)\\ \{o_i\}_{i=1}^G\sim\pi_{\theta_{\mathrm{old}}}(\cdot\mid q) }} \left[ \frac1G\sum_{i=1}^G \frac1{T_i}\sum_{t=1}^{T_i} \widehat D_{\mathrm{KL},i,t}(\theta) \right]
J GRPO KL ( θ ) = q ∼ P ( Q ) { o i } i = 1 G ∼ π θ old ( ⋅ ∣ q ) E [ G 1 i = 1 ∑ G T i 1 t = 1 ∑ T i D KL , i , t ( θ ) ] J G R P O ( θ ) = J G R P O c l i p ( θ ) − β J G R P O K L ( θ )
J_{\mathrm{GRPO}}(\theta) = J_{\mathrm{GRPO}}^{\mathrm{clip}}(\theta) -\beta J_{\mathrm{GRPO}}^{\mathrm{KL}}(\theta)
J GRPO ( θ ) = J GRPO clip ( θ ) − β J GRPO KL ( θ ) GRPO 中的 KL 设计展开又是一个可以讲很久的 topic,我们暂时在此处忽略。具体可以参考 http://joschu.net/blog/kl-approx.html 这里的 KL Approximations
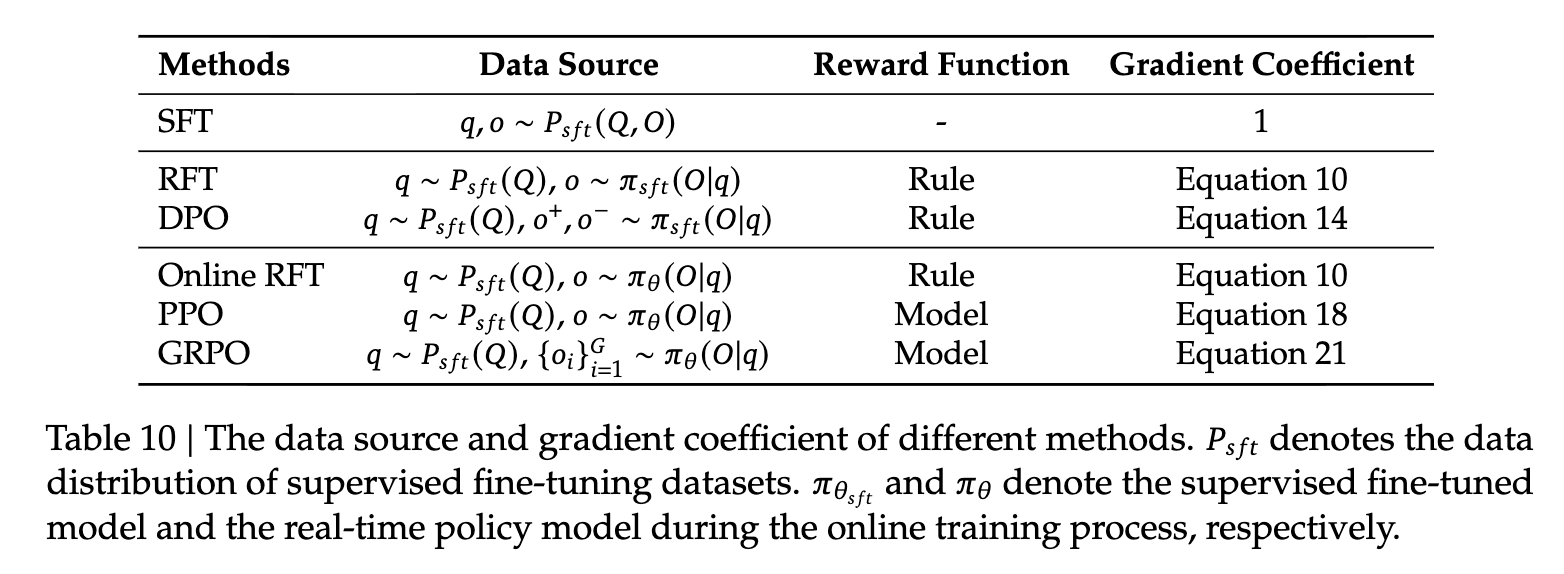
Summary# 在 DeepSeek-Math 的论文中,将所有的 RL 和训练算法统一起来,形成了一个实在精彩的段落,在本章节进行细节诠释 (https://arxiv.org/pdf/2402.03300 , 5.2: Insights of Reinforcement Learning)
In this section, we provide a unified paradigm to analyze different training methods, such as SFT, RFT, DPO, PPO, GRPO , and further conduct experiments to explore the factors of the unified paradigm.
Generally, the gradient with respect to the parameter θ \theta θ
∇ θ J A ( θ ) = E [ ( q , o ) ∼ D ⏟ D a t a S o u r c e ] ( 1 ∣ o ∣ ∑ t = 1 ∣ o ∣ G C A ( q , o , t , π r f ) ⏟ G r a d i e n t C o e f f i c i e n t ∇ θ log π θ ( o t ∣ q , o < t ) ) .
\nabla_{\theta}\mathcal{J}_{\textcolor{red}{\mathcal{A}}}(\theta) = \mathbb{E}[\underbrace{(q,o) \sim \textcolor{red}{\mathcal{D}}}_{Data \ Source}]\left( \frac{1}{|o|} \sum_{t=1}^{|o|} \underbrace{GC_{{\mathcal{A}}}(q, o, t, \textcolor{red}{\pi_{{rf}}})}_{Gradient \ Coefficient} \nabla_{\theta}\log \pi_{\theta}(o_t | q, o_{<t})\right).
∇ θ J A ( θ ) = E [ D a t a S o u r ce ( q , o ) ∼ D ] ∣ o ∣ 1 t = 1 ∑ ∣ o ∣ G r a d i e n t C oe f f i c i e n t G C A ( q , o , t , π r f ) ∇ θ log π θ ( o t ∣ q , o < t ) . Data Source D \mathcal{D} D Reward Function π r f \pi_{{rf}} π r f Algorithm A \mathcal{A} A G C GC GC 如何理解 Gradient Coefficient? 在上文,核心的梯度通过 Policy Gradient 被传导到 ∇ θ log π θ ( o t ∣ q , o < t ) \nabla_{\theta}\log \pi_{\theta}(o_t | q, o_{<t}) ∇ θ log π θ ( o t ∣ q , o < t )
G C > 0 GC>0 GC > 0 G C < 0 GC<0 GC < 0 ∣ G C ∣ |GC| ∣ GC ∣ G C = 0 GC=0 GC = 0
SFT# SFT 的目标是最大化正确答案的 Log Likelihood:
J S F T ( θ ) = E ( q , o ) ∼ D S F T [ 1 ∣ o ∣ ∑ t log π θ ( o t ∣ s t ) ]
J_{\mathrm{SFT}}(\theta) = \mathbb E_{(q,o)\sim\mathcal D_{\mathrm{SFT}}} \left[ \frac1{|o|}\sum_t\log\pi_\theta(o_t\mid s_t) \right]
J SFT ( θ ) = E ( q , o ) ∼ D SFT [ ∣ o ∣ 1 t ∑ log π θ ( o t ∣ s t ) ] 直接求导:
∇ θ J S F T = E [ 1 ∣ o ∣ ∑ t 1 ⏟ G C S F T ∇ θ log π θ ( o t ∣ s t ) ]
\nabla_\theta J_{\mathrm{SFT}} = \mathbb E\left[ \frac1{|o|}\sum_t \underbrace{1}_{GC_{\mathrm{SFT}}} \nabla_\theta\log\pi_\theta(o_t\mid s_t) \right ]
∇ θ J SFT = E ∣ o ∣ 1 t ∑ G C SFT 1 ∇ θ log π θ ( o t ∣ s t ) 因此,在 SFT 中,所有数据集中的 token 都被赋予了相同的梯度。
RFT && Online RFT# RFT(Rejection Sampling Fine-tuning) 的数据池是 SFT 采样出来的数据。先从模型采样 Responses,然后通过 Verifier 判断结果:
I ( o ) = { 1 , 答案正确 0 , 答案错误 \mathbb I(o)= \begin{cases} 1,&\text{答案正确}\\ 0,&\text{答案错误} \end{cases} I ( o ) = { 1 , 0 , 答案正确 答案错误 于是:
G C R F T = I ( o )
GC_{\mathrm{RFT}}=\mathbb I(o)
G C RFT = I ( o ) 对于 Online RFT,GC 没有变化,只是数据是从实时的 Policy θ \theta θ
DPO# DPO 在静态偏好数据集上进行训练,GC 的具体表现形式如下:
G C D P O ( q , o , t ) = σ ( β log π θ ( o t − ∣ q , o < t − ) π ref ( o t − ∣ q , o < t − ) − β log π θ ( o t + ∣ q , o < t + ) π ref ( o t + ∣ q , o < t + ) )
GC_{DPO}(q,o,t) = \sigma\left(\beta\log \frac{\pi_{\theta}(o^-_t | q, o^-_{<t})}{\pi_{\text{ref}}(o^-_t | q, o^-_{<t})} - \beta\log \frac{\pi_{\theta}(o^+_t | q, o^+_{<t})}{\pi_{\text{ref}}(o^+_t | q, o^+_{<t})}\right)
G C D P O ( q , o , t ) = σ ( β log π ref ( o t − ∣ q , o < t − ) π θ ( o t − ∣ q , o < t − ) − β log π ref ( o t + ∣ q , o < t + ) π θ ( o t + ∣ q , o < t + ) ) PPO# 对 PPO 来说,就是 GAE 估计的 Advantage,对于大于 0 的 advantage 的 token 梯度强化,对于小于 0 的 advantage 的 token 梯度施加惩罚。
G C P P O ( q , o , t ) = A ^ t G A E
GC_{\mathrm{PPO}}(q,o,t)=\hat A_t^{\mathrm{GAE}}
G C PPO ( q , o , t ) = A ^ t GAE 其中:
A ^ t G A E = ∑ l = 0 T − t ( γ λ ) l δ t + l
\hat A_t^{\mathrm{GAE}} = \sum_{l=0}^{T-t}(\gamma\lambda)^l\delta_{t+l}
A ^ t GAE = l = 0 ∑ T − t ( γ λ ) l δ t + l 这里的 PPO 是指最初始的 PPO 形式,没有加上 KL 散度项 (不是 RLHF-PPO)
GRPO# 原始 GRPO 的目标包含,在这里暂时忽略 off-policy,假设 π θ = π old \pi_{\theta} = \pi_{\text{old}} π θ = π old
J G R P O = J c l i p − β J K L
J_{\mathrm{GRPO}} = J_{\mathrm{clip}}-\beta J_{\mathrm{KL}}
J GRPO = J clip − β J KL 其中单 Token 的 KL Estimator 是:
k t = π r e f ( o t ∣ s t ) π θ ( o t ∣ s t ) − log π r e f ( o t ∣ s t ) π θ ( o t ∣ s t ) − 1
k_t= \frac{\pi_{\mathrm{ref}}(o_t\mid s_t)} {\pi_\theta(o_t\mid s_t)} -\log\frac{\pi_{\mathrm{ref}}(o_t\mid s_t)} {\pi_\theta(o_t\mid s_t)}-1
k t = π θ ( o t ∣ s t ) π ref ( o t ∣ s t ) − log π θ ( o t ∣ s t ) π ref ( o t ∣ s t ) − 1 令 r t = π r e f ( o t ∣ s t ) π θ ( o t ∣ s t ) r_t=\frac{\pi_{\mathrm{ref}}(o_t\mid s_t)} {\pi_\theta(o_t\mid s_t)} r t = π θ ( o t ∣ s t ) π ref ( o t ∣ s t )
∇ θ r t = − r t ∇ θ log π θ ( o t ∣ s t )
\nabla_\theta r_t = -r_t\nabla_\theta\log\pi_\theta(o_t\mid s_t)
∇ θ r t = − r t ∇ θ log π θ ( o t ∣ s t ) 因此:
∇ θ ( − β k t ) = − β ∇ θ ( r t − log r t − 1 ) = β ( r t − 1 ) ∇ θ log π θ ( o t ∣ s t )
\begin{aligned} \nabla_\theta(-\beta k_t) &=-\beta\nabla_\theta(r_t-\log r_t-1)\\ &=\beta(r_t-1)\nabla_\theta\log\pi_\theta(o_t\mid s_t) \end{aligned}
∇ θ ( − β k t ) = − β ∇ θ ( r t − log r t − 1 ) = β ( r t − 1 ) ∇ θ log π θ ( o t ∣ s t ) 因此,GRPO 的这一部分可以被写为 Grouped Advantages 和 KL 梯度计算 的部分。从几何意义上,也非常明显:
在组间具备优势,得到正向的 GC 如果 ref-model 产生这个 token 的概率更大,此时说明当前 Policy 相比于 Reference Model,低估了这个 Token 的概率。(拉回来) GRPO 两项的 GC 是两个独立的梯度,前者希望给得到正确 response 的 value 更高的价值,后者希望给偏离于 ref-model 的 token 一些很大的惩罚。
G C G R P O ( q , o , t , π θ r m ) = A ^ i , t + β ( π r e f ( o i , t ∣ o i , < t ) π θ ( o i , t ∣ o i , < t ) − 1 )
GC_{GRPO}(q, o, t, \pi_{\theta_{rm}}) = \hat{A}_{i,t} + \beta \left(\frac{\pi_{ref}(o_{i,t}|o_{i,<t})}{\pi_{\theta}(o_{i,t}|o_{i,<t})} - 1\right)
G C GR P O ( q , o , t , π θ r m ) = A ^ i , t + β ( π θ ( o i , t ∣ o i , < t ) π r e f ( o i , t ∣ o i , < t ) − 1 ) OPD# On Policy Distillation 是一个比较新颖的 RL 方式,通过引入教师模型,给予 teacher-level 的 token 信号监督,可以实现更稠密的监督信号。OPD 的数据来自 Student 自己生成的 Rollout,但监督信号来自 Teacher 对 Student 所访问的 Prefix 给出的概率分布。
固定一个 Prefix s s s
D K L ( p θ ∥ p T ) = ∑ v ∈ V p θ ( v ∣ s ) log p θ ( v ∣ s ) p T ( v ∣ s )
D_{\mathrm{KL}}(p_\theta\Vert p_T) = \sum_{v\in\mathcal V} p_\theta(v\mid s) \log\frac{p_\theta(v\mid s)}{p_T(v\mid s)}
D KL ( p θ ∥ p T ) = v ∈ V ∑ p θ ( v ∣ s ) log p T ( v ∣ s ) p θ ( v ∣ s ) 如果写成最大化目标:J O P D ( θ ; s ) = − D K L ( p θ ∥ p T ) J_{\mathrm{OPD}}(\theta;s) = -D_{\mathrm{KL}}(p_\theta\Vert p_T) J OPD ( θ ; s ) = − D KL ( p θ ∥ p T )
和 RL 一样,如法炮制展开求梯度:
J O P D = − ∑ v p θ ( v ∣ s ) log p θ ( v ∣ s ) p T ( v ∣ s )
J_{\mathrm{OPD}} = -\sum_vp_\theta(v\mid s) \log\frac{p_\theta(v\mid s)}{p_T(v\mid s)}
J OPD = − v ∑ p θ ( v ∣ s ) log p T ( v ∣ s ) p θ ( v ∣ s )
∇ θ J O P D = − ∑ v ∇ θ p θ ( v ∣ s ) ( log p θ ( v ∣ s ) p T ( v ∣ s ) + 1 )
\begin{aligned} \nabla_\theta J_{\mathrm{OPD}} ={}&-\sum_v\nabla_\theta p_\theta(v\mid s) \left( \log\frac{p_\theta(v\mid s)}{p_T(v\mid s)}+1 \right) \end{aligned}
∇ θ J OPD = − v ∑ ∇ θ p θ ( v ∣ s ) ( log p T ( v ∣ s ) p θ ( v ∣ s ) + 1 ) 我们再次利用零均值性质: ∑ v ∇ θ p θ ( v ∣ s ) = 0 \sum_v\nabla_\theta p_\theta(v\mid s)=0 ∑ v ∇ θ p θ ( v ∣ s ) = 0
∇ θ J O P D = − ∑ v ∇ θ p θ ( v ∣ s ) log p θ ( v ∣ s ) p T ( v ∣ s ) = ∑ v p θ ( v ∣ s ) log p T ( v ∣ s ) p θ ( v ∣ s ) ∇ θ log p θ ( v ∣ s )
\begin{aligned} \nabla_\theta J_{\mathrm{OPD}} &= -\sum_v\nabla_\theta p_\theta(v\mid s) \log\frac{p_\theta(v\mid s)}{p_T(v\mid s)}\\ &= \sum_vp_\theta(v\mid s) \log\frac{p_T(v\mid s)}{p_\theta(v\mid s)} \nabla_\theta\log p_\theta(v\mid s) \end{aligned}
∇ θ J OPD = − v ∑ ∇ θ p θ ( v ∣ s ) log p T ( v ∣ s ) p θ ( v ∣ s ) = v ∑ p θ ( v ∣ s ) log p θ ( v ∣ s ) p T ( v ∣ s ) ∇ θ log p θ ( v ∣ s )
∇ θ J O P D ( θ ; s ) = E v ∼ p θ ( ⋅ ∣ s ) [ log p T ( v ∣ s ) p θ ( v ∣ s ) ⏟ G C O P D ∇ θ log p θ ( v ∣ s ) ]
\nabla_\theta J_{\mathrm{OPD}}(\theta;s) = \mathbb E_{v\sim p_\theta(\cdot\mid s)} \left[ \underbrace{ \log\frac{p_T(v\mid s)}{p_\theta(v\mid s)} }_{GC_{\mathrm{OPD}}} \nabla_\theta\log p_\theta(v\mid s) \right]
∇ θ J OPD ( θ ; s ) = E v ∼ p θ ( ⋅ ∣ s ) G C OPD log p θ ( v ∣ s ) p T ( v ∣ s ) ∇ θ log p θ ( v ∣ s ) 因此,对于常见的 Reverse-KL On-Policy Distillation,在固定 Token Prefix 上使用当前 Student Policy 采样时,可以得到:
G C O P D ( q , o , t ) = log π t e a c h e r ( o t ∣ q , o < t ) π θ ( o t ∣ q , o < t )
GC_{\mathrm{OPD}}(q,o,t) = \log\frac{ \pi_{\mathrm{teacher}}(o_t\mid q,o_{<t}) }{ \pi_\theta(o_t\mid q,o_{<t})}
G C OPD ( q , o , t ) = log π θ ( o t ∣ q , o < t ) π teacher ( o t ∣ q , o < t ) On the Insights of Distributions: SFT, RL, OPD# KL Divergence# 我们关注的问题就是从算法原理角度,能否统一所有的后训练算法? 下面的这篇推文从 KL 散度的视角出发,给出了详细的解释。
相关链接:
首先,我们重新给出 KL 散度的数学定义,KL 散度的作用是衡量两个概率分布之间的差异情况,但优化方向不同,会导致截然不同的行为:Forward KL 倾向于 Mode Covering(覆盖多个模式),Reverse KL 倾向于 Mode Seeking(集中于某个模式)。
假设有两个概率分布:
P ( x ) P(x) P ( x ) Q θ ( x ) Q_\theta(x) Q θ ( x ) θ \theta θ KL Divergence(相对熵)定义为:
D K L ( P ∥ Q ) = E x ∼ P [ log P ( x ) Q ( x ) ]
D_{\mathrm{KL}}(P\|Q)=\mathbb E_{x\sim P}\left[\log\frac{P(x)}{Q(x)}\right]
D KL ( P ∥ Q ) = E x ∼ P [ log Q ( x ) P ( x ) ] 对于离散分布:
D K L ( P ∥ Q ) = ∑ x P ( x ) log P ( x ) Q ( x )
D_{\mathrm{KL}}(P\|Q)=\sum_x P(x)\log\frac{P(x)}{Q(x)}
D KL ( P ∥ Q ) = x ∑ P ( x ) log Q ( x ) P ( x ) 对于连续分布:
D K L ( P ∥ Q ) = ∫ P ( x ) log P ( x ) Q ( x ) d x
D_{\mathrm{KL}}(P\|Q)=\int P(x)\log\frac{P(x)}{Q(x)}dx
D KL ( P ∥ Q ) = ∫ P ( x ) log Q ( x ) P ( x ) d x KL 分布有两个重要的数学性质:
D K L ( P ∥ Q ) ≥ 0 D_{\mathrm{KL}}(P\|Q)\geq 0 D KL ( P ∥ Q ) ≥ 0 D K L ( P ∥ Q ) = 0 ⟺ P = Q D_{\mathrm{KL}}(P\|Q)=0\iff P=Q D KL ( P ∥ Q ) = 0 ⟺ P = Q 但是,KL 散度不是对称的,如果交换 Q 和 P 的位置,会产生不同的优化目标: D K L ( P ∥ Q ) ≠ D K L ( Q ∥ P ) D_{\mathrm{KL}}(P\|Q)\neq D_{\mathrm{KL}}(Q\|P) D KL ( P ∥ Q ) = D KL ( Q ∥ P )
Forward KL & Reverse KL# Forward KL:
D K L ( P ∥ Q θ ) = E x ∼ P [ log P ( x ) Q θ ( x ) ] = E x ∼ P [ log P ( x ) ] − E x ∼ P [ log Q θ ( x ) ]
D_{\mathrm{KL}}(P\|Q_{\theta})=\mathbb E_{x\sim P}\left[\log\frac{P(x)}{Q_{\theta}(x)}\right] = E_{x\sim P}\left[\log P(x)\right] - E_{x\sim P}\left[\log Q_{\theta}(x)\right]
D KL ( P ∥ Q θ ) = E x ∼ P [ log Q θ ( x ) P ( x ) ] = E x ∼ P [ log P ( x ) ] − E x ∼ P [ log Q θ ( x ) ] 因为前一项是针对 P(目标分布)的一个固定值,和 θ \theta θ Forward KL 要求模型尽可能提高目标分布中真实样本的概率。
这本质上就是最大似然估计! 我们需要找到最优的参数 θ \theta θ
Reverse KL 对当前参数分布中进行采样,检验该分布在目标分布中出现的比例。
D K L ( Q θ ∥ P ) = E x ∼ Q θ [ log Q θ ( x ) P ( x ) ]
D_{\mathrm{KL}}(Q_\theta\|P) =\mathbb E_{x\sim Q_\theta}\left[\log\frac{Q_\theta(x)}{P(x)}\right]
D KL ( Q θ ∥ P ) = E x ∼ Q θ [ log P ( x ) Q θ ( x ) ] 展开:
D K L ( Q θ ∥ P ) = E Q θ [ log Q θ ( x ) ] − E Q θ [ log P ( x ) ]
D_{\mathrm{KL}}(Q_\theta\|P) =\mathbb E_{Q_\theta}[\log Q_\theta(x)] -\mathbb E_{Q_\theta}[\log P(x)]
D KL ( Q θ ∥ P ) = E Q θ [ log Q θ ( x )] − E Q θ [ log P ( x )] 注意到 H ( Q θ ) = − E Q θ [ log Q θ ( x ) ] H(Q_\theta)=-\mathbb E_{Q_\theta}[\log Q_\theta(x)] H ( Q θ ) = − E Q θ [ log Q θ ( x )]
因此:D K L ( Q θ ∥ P ) = − H ( Q θ ) − E Q θ [ log P ( x ) ] D_{\mathrm{KL}}(Q_\theta\|P) =-H(Q_\theta)-\mathbb E_{Q_\theta}[\log P(x)] D KL ( Q θ ∥ P ) = − H ( Q θ ) − E Q θ [ log P ( x )]
所以最小化 Reverse KL 等价于最大化:
max θ ( E x ∼ Q θ [ log P ( x ) ] + H ( Q θ ) )
\max_\theta\left( \mathbb E_{x\sim Q_\theta}[\log P(x)] +H(Q_\theta) \right)
θ max ( E x ∼ Q θ [ log P ( x )] + H ( Q θ ) ) 这里的目标函数有两项组成:
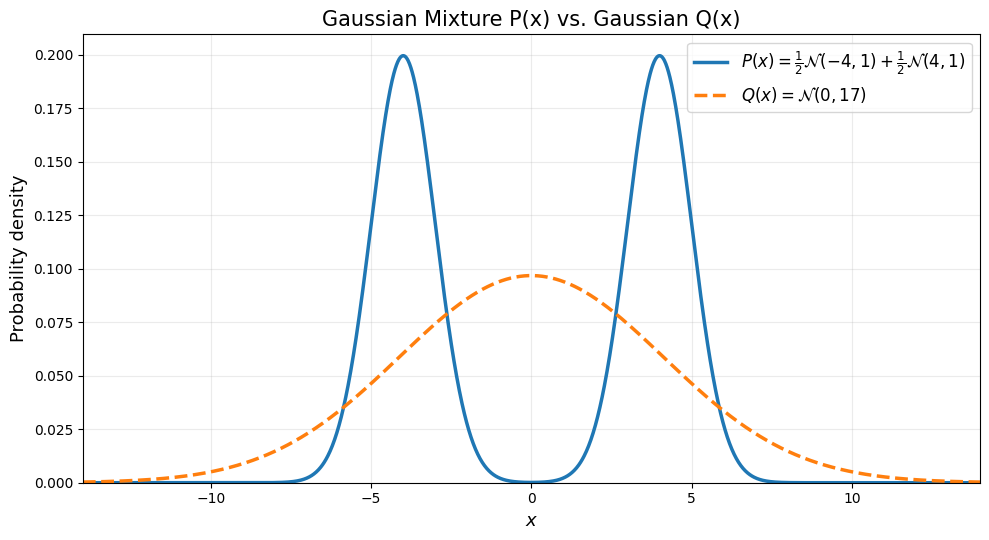
第一项约束在当前模型采样的区域,P(x) 必须需要有很高的概率 第二项约束了自身分布的熵,熵过小说明分布坍缩了 Mode Seeking & Mode Covering# 我们考虑极端的情况,假设在前向 KL 中,存在 P ( x ) > 0 , Q ( x ) → 0 P(x) > 0, Q(x) \to 0 P ( x ) > 0 , Q ( x ) → 0 前向 KL 会严重惩罚那些在当前分布中缺乏,但是在目标分布中存在 的分布,展现为 Mode Covering (覆盖目标分布,哪怕方差很大)
举一个具体的例子, 考虑一个目标分布有两个模式,我们在前向 KL 作为优化目标的情况下,尝试使用单峰去拟合双峰:
P ( x ) = 1 2 N ( − 4 , 1 ) + 1 2 N ( 4 , 1 )
P(x)=\frac12\mathcal N(-4,1)+\frac12\mathcal N(4,1)
P ( x ) = 2 1 N ( − 4 , 1 ) + 2 1 N ( 4 , 1 ) Q θ ( x ) = N ( μ , σ 2 )
Q_\theta(x)=\mathcal N(\mu,\sigma^2)
Q θ ( x ) = N ( μ , σ 2 ) 由于:
log Q θ ( x ) = − 1 2 log ( 2 π σ 2 ) − ( x − μ ) 2 2 σ 2
\log Q_\theta(x) =-\frac12\log(2\pi\sigma^2) -\frac{(x-\mu)^2}{2\sigma^2}
log Q θ ( x ) = − 2 1 log ( 2 π σ 2 ) − 2 σ 2 ( x − μ ) 2 所以最小化 Forward KL 等价于最小化:
L ( μ , σ 2 ) = 1 2 log ( 2 π σ 2 ) + E P [ ( x − μ ) 2 ] 2 σ 2
\mathcal L(\mu,\sigma^2) =\frac12\log(2\pi\sigma^2) +\frac{\mathbb E_P[(x-\mu)^2]}{2\sigma^2}
L ( μ , σ 2 ) = 2 1 log ( 2 π σ 2 ) + 2 σ 2 E P [( x − μ ) 2 ] 对两个参数分别求导得到 0,可以得到:
μ ∗ = E P [ x ] = 0 \mu^*=\mathbb E_P[x] = 0 μ ∗ = E P [ x ] = 0 ( σ 2 ) ∗ = V a r P ( x ) = 17 (\sigma^2)^*=\mathrm{Var}_P(x) = 17 ( σ 2 ) ∗ = Var P ( x ) = 17
对于 reverse kl,情况会不一样,因为此时数据是在 P ( x ) P(x) P ( x )
max θ ( E x ∼ Q θ [ log P ( x ) ] + H ( Q θ ) )
\max_\theta\left( \mathbb E_{x\sim Q_\theta}[\log P(x)] +H(Q_\theta) \right)
θ max ( E x ∼ Q θ [ log P ( x )] + H ( Q θ ) ) 首先,Q 本身的分布不可以过于尖锐(熵的约束) 其次,只需要在 Q 分布的区域,目标分布的出现概率较大即可 因此,目标参数不会选择拟合 P 分布中所有的 Mode,而是会选择性找到一个比较温和的局部分布,使其具备一定拟合性即可,因此我们把这种定义为 Mode Seeking .
SFT: Off-Policy, Mode-Covering, Forward-KL# 定义 Forward KL:
D K L ( p d a t a ∥ q θ ) = E x ∼ p d a t a [ log p d a t a ( x ) q θ ( x ) ]
D_{\mathrm{KL}}(p_{\mathrm{data}}\|q_\theta) =\mathbb E_{x\sim p_{\mathrm{data}}} \left[\log\frac{p_{\mathrm{data}}(x)}{q_\theta(x)}\right]
D KL ( p data ∥ q θ ) = E x ∼ p data [ log q θ ( x ) p data ( x ) ] 因此, KL 散度可以被写成:
D K L ( p d a t a ∥ q θ ) = E p d a t a [ log p d a t a ( x ) ] − E p d a t a [ log q θ ( x ) ] = − H ( p d a t a ) + H ( p d a t a , q θ )
\begin{aligned} D_{\mathrm{KL}}(p_{\mathrm{data}}\|q_\theta) &=\mathbb E_{p_{\mathrm{data}}}[\log p_{\mathrm{data}}(x)]\\ &\quad-\mathbb E_{p_{\mathrm{data}}}[\log q_\theta(x)]\\ &=-H(p_{\mathrm{data}})+H(p_{\mathrm{data}},q_\theta) \end{aligned}
D KL ( p data ∥ q θ ) = E p data [ log p data ( x )] − E p data [ log q θ ( x )] = − H ( p data ) + H ( p data , q θ ) 第一项是静态数据的分布熵,是一个固定值 第二项是模型参数和数据分布的 cross-entropy,这也是我们需要最小化的目标 而我们在上文证明了,前向 KL 散度本质上就是 MLE(最大似然估计),而 SFT 的目标本质也只是一种最大似然估计!
max θ ∏ i = 1 N q θ ( y i ∣ x i ) \max_\theta \prod_{i=1}^{N}q_\theta(y_i|x_i) max θ ∏ i = 1 N q θ ( y i ∣ x i ) max θ ∑ i = 1 N log q θ ( y i ∣ x i ) \max_\theta\sum_{i=1}^{N}\log q_\theta(y_i|x_i) max θ ∑ i = 1 N log q θ ( y i ∣ x i ) L S F T = − 1 N ∑ i = 1 N log q θ ( y i ∣ x i ) \mathcal L_{\mathrm{SFT}} =-\frac1N\sum_{i=1}^{N}\log q_\theta(y_i|x_i) L SFT = − N 1 ∑ i = 1 N log q θ ( y i ∣ x i )
因此,SFT 的优化目标本质上就是 forward KL 散度,算法需要强制拟合数据集内部出现的所有文本模式,是一种优化强度很高的拟合方式。因此,对 SFT 来说,梯度会被均匀的施加在所有的 token 梯度上,导致模型产生灾难性遗忘等严重问题。
RL: On-Policy, Mode-Seeking, Reverse-KL# 对于 RL 来说,是一种 On Policy 的算法,同时依靠策略梯度提升序列期望奖励。
我们考虑 RLHF-PPO 的优化目标:
max θ J ( θ ) = E y ∼ q θ [ R ( x , y ) ] − β D K L ( q θ ∥ q r e f )
\max_\theta J(\theta) = \mathbb E_{y\sim q_\theta}[R(x,y)] -\beta D_{\mathrm{KL}}(q_\theta\|q_{\mathrm{ref}})
θ max J ( θ ) = E y ∼ q θ [ R ( x , y )] − β D KL ( q θ ∥ q ref ) 展开 Reverse KL:
D K L ( q θ ∥ q r e f ) = E y ∼ q θ [ log q θ ( y ∣ x ) q r e f ( y ∣ x ) ]
D_{\mathrm{KL}}(q_\theta\|q_{\mathrm{ref}}) = \mathbb E_{y\sim q_\theta} \left[\log\frac{q_\theta(y|x)}{q_{\mathrm{ref}}(y|x)}\right]
D KL ( q θ ∥ q ref ) = E y ∼ q θ [ log q ref ( y ∣ x ) q θ ( y ∣ x ) ] 代入并合并期望:
J ( θ ) = E q θ [ R ( x , y ) ] − β E q θ [ log q θ ( y ∣ x ) q r e f ( y ∣ x ) ]
\begin{aligned} J(\theta) &=\mathbb E_{q_\theta}[R(x,y)]\\ &\quad-\beta\mathbb E_{q_\theta} \left[\log\frac{q_\theta(y|x)}{q_{\mathrm{ref}}(y|x)}\right] \end{aligned}
J ( θ ) = E q θ [ R ( x , y )] − β E q θ [ log q ref ( y ∣ x ) q θ ( y ∣ x ) ]
J ( θ ) = E q θ [ R ( x , y ) − β log q θ ( y ∣ x ) q r e f ( y ∣ x ) ]
J(\theta) = \mathbb E_{q_\theta}\left[ R(x,y) -\beta\log\frac{q_\theta(y|x)}{q_{\mathrm{ref}}(y|x)} \right]
J ( θ ) = E q θ [ R ( x , y ) − β log q ref ( y ∣ x ) q θ ( y ∣ x ) ] 我们构造一个新的概率分布, Z ( x ) Z(x) Z ( x ) Z ( x ) = ∑ y q r e f ( y ∣ x ) exp ( R ( x , y ) β ) Z(x) = \sum_y q_{\mathrm{ref}}(y|x) \exp\left(\frac{R(x,y)}{\beta}\right) Z ( x ) = ∑ y q ref ( y ∣ x ) exp ( β R ( x , y ) ) Reference Model 的原始分布基础上 ,根据 Reward 重新加权后得到的理想目标分布。
p r e w a r d ( y ∣ x ) = 1 Z ( x ) q r e f ( y ∣ x ) exp ( R ( x , y ) β )
p_{\mathrm{reward}}(y|x) = \frac{1}{Z(x)} q_{\mathrm{ref}}(y|x) \exp\left(\frac{R(x,y)}{\beta}\right)
p reward ( y ∣ x ) = Z ( x ) 1 q ref ( y ∣ x ) exp ( β R ( x , y ) ) 根据定义:
log p r e w a r d ( y ∣ x ) = log q r e f ( y ∣ x ) + R ( x , y ) β − log Z ( x )
\log p_{\mathrm{reward}}(y|x) = \log q_{\mathrm{ref}}(y|x) +\frac{R(x,y)}{\beta} -\log Z(x)
log p reward ( y ∣ x ) = log q ref ( y ∣ x ) + β R ( x , y ) − log Z ( x )
D K L ( q θ ∥ p r e w a r d ) = E q θ [ log q θ ( y ∣ x ) p r e w a r d ( y ∣ x ) ]
D_{\mathrm{KL}}(q_\theta\|p_{\mathrm{reward}}) = \mathbb E_{q_\theta} \left[\log\frac{q_\theta(y|x)}{p_{\mathrm{reward}}(y|x)}\right]
D KL ( q θ ∥ p reward ) = E q θ [ log p reward ( y ∣ x ) q θ ( y ∣ x ) ]
D K L ( q θ ∥ p r e w a r d ) = E q θ [ log q θ ( y ∣ x ) − log q r e f ( y ∣ x ) − R ( x , y ) β + log Z ( x ) ]
\begin{aligned} &D_{\mathrm{KL}}(q_\theta\|p_{\mathrm{reward}})\\ &=\mathbb E_{q_\theta}\left[ \log q_\theta(y|x) -\log q_{\mathrm{ref}}(y|x) -\frac{R(x,y)}{\beta} +\log Z(x) \right] \end{aligned}
D KL ( q θ ∥ p reward ) = E q θ [ log q θ ( y ∣ x ) − log q ref ( y ∣ x ) − β R ( x , y ) + log Z ( x ) ] 整理可以得到:
D K L ( q θ ∥ p r e w a r d ) = D K L ( q θ ∥ q r e f ) − 1 β E q θ [ R ( x , y ) ] + log Z ( x ) = − 1 β [ E q θ [ R ( x , y ) − β D K L ( q θ ∥ q r e f ) ] + log Z ( x )
\begin{aligned} D_{\mathrm{KL}}(q_\theta\|p_{\mathrm{reward}}) &= D_{\mathrm{KL}}(q_\theta\|q_{\mathrm{ref}})-\frac1\beta\mathbb E_{q_\theta}[R(x,y)] +\log Z(x) \\ &= -\frac1\beta [\mathbb E_{q_\theta}[R(x,y) - \beta D_{\mathrm{KL}}(q_\theta\|q_{\mathrm{ref}})]+ \log Z(x)\end{aligned}
D KL ( q θ ∥ p reward ) = D KL ( q θ ∥ q ref ) − β 1 E q θ [ R ( x , y )] + log Z ( x ) = − β 1 [ E q θ [ R ( x , y ) − β D KL ( q θ ∥ q ref )] + log Z ( x ) 由于 β \beta β Z ( x ) Z(x) Z ( x ) θ \theta θ
OPD: On-Policy, Reverse-KL# 固定一个 Prefix s s s
D K L ( p θ ∥ p T ) = ∑ v ∈ V p θ ( v ∣ s ) log p θ ( v ∣ s ) p T ( v ∣ s )
D_{\mathrm{KL}}(p_\theta\Vert p_T) = \sum_{v\in\mathcal V} p_\theta(v\mid s) \log\frac{p_\theta(v\mid s)}{p_T(v\mid s)}
D KL ( p θ ∥ p T ) = v ∈ V ∑ p θ ( v ∣ s ) log p T ( v ∣ s ) p θ ( v ∣ s ) 如果写成最大化目标:J O P D ( θ ; s ) = − D K L ( p θ ∥ p T ) J_{\mathrm{OPD}}(\theta;s) = -D_{\mathrm{KL}}(p_\theta\Vert p_T) J OPD ( θ ; s ) = − D KL ( p θ ∥ p T )
因为 OPD 的信号监督细化到了 token 级别,因此,一般的 OPD 会要求模型必须使用相同的 tokenizer 和词表进行训练,保证最后输出层的语义 logits 对齐。目前学术界也在研究一些前沿的 OPD 技巧,让跨次表的 token mapping 成为可能。
OPD 相比于纯 RL 具备更完善的奖励信号,因此现在业界的通用范式往往是: SFT 出一个专家模型,通过 OPD/MOPD 等方式对学生模型进行训练。一方面 OPD 也可以缓解 SFT 的灾难性遗忘的问题。
最优策略集合存在无数可行分布,RL仅在模型当前采样邻域内寻优,自动选择与原始模型KL距离最小 的最优分布,全程不会强行拉扯至遥远外部分布。OPD继承这套On-Policy约束,因此哪怕教师存在能力退化,学生也不会完全复刻教师的缺陷分布。