在 Series2,我们介绍了一系列将强化学习引入大语言模型后训练的核心工作 (RLHF 时代, RLVR 时代),RLVR 最鼎盛的时代是 DeepSeek-V3 的爆火 (2024 年末),随着强化学习理论和大模型的进一步发展,如今强化学习进入 Agentic RL 的时代,这个时代最大的特点是:
- 模型架构越来越复杂,RL 本身很多细节需要适配新的大语言模型架构
- Agent 成为语言模型和真实世界交互反馈的框架,但是 Agent 天生需要多轮 agentic llm 的交互能力,往往存在 TITO 不一致、训推不一致、任务分布长尾等情况,需要在强化学习算法内部被解决。
因此,本讲将会重点介绍两个部分:
- 后 RLVR 时代: 基于 GRPO 算法的一系列算法变体改进: GRPO (in DeepSeek-V3.2), DAPO, GSPO
- GRPO in DeepSeek-V3.2: https://arxiv.org/pdf/2512.02556
- DAPO: https://arxiv.org/pdf/2503.14476
- GSPO: https://arxiv.org/pdf/2507.18071
- Long-Horizon Agentic RL: 从 RLVR 迈向 long-horizon!
- Survey: https://www.preprints.org/manuscript/202607.1328
- SAO: https://arxiv.org/pdf/2607.07508
- QwenGyre: https://arxiv.org/pdf/2609.33848
- FlashReinforcement: https://github.com/yifanzhang-pro/FlashREINFORCE
GRPO Variants
GRPO in DeepSeek-V3.2
在 DeepSeek-V3.2 的技术报告中,基于原始版本的 GRPO 提出了进一步版本的 Scaling-GRPO,Scaling GRPO 并不是重新设计 GRPO 的核心 Policy Gradient 算法,而是围绕大规模 RL 训练中出现的梯度偏差、Off-Policy 问题以及训练与推理不一致问题,提出四项稳定性优化。四项优化的关键都指向同一个问题:如何解决 RL 训练中训推不一致的问题?
A. Policy Optimization 层面 (使梯度估计更可靠,并控制离策略更新的风险) 1. Unbiased KL Estimate: 修正梯度偏差 2. Off-Policy Sequence Masking: 筛除高风险更新 B. Training Infrastructure 层面 (使 Rollout 与 Training 使用一致的计算语义) 3. Keep Routing: 参数激活路径一致 4. Keep Sampling Mask: Token 动作空间一致
Unbiased KL Estimate
GRPO 定义中,KL 散度项可以被写为,但是需要遍历词表。
在传统的 GRPO 中,使用 K3 Estimator 来对 KL 散度项进行估计,K3 估计是基于数学原理的推导实现的(保证无偏性的同时,降低方差),目的是通过 MCMC 的方式,使得可以在不遍历词表的前提下,只对生成的 token 的 log-prob 进行估计,生成 KL 散度的估计值
但是 GRPO 存在一个问题,就是在一个 iteration 内部,数据 rollout 和梯度更新是串行的关系,也就是在 iteration 内部是使用旧数据产生的梯度来更新已经被更新多次的新模型,是一种 off-policy 的关系! 但是 KL 项应该在真实 中被采样,而 Vanilla-GRPO 中使用的是旧策略的数据且未加重要性采样。也就是说:
更进一步分析梯度,令 ,。原式写为:
在这里,Mode-Seeking 范式被写成了 Mode-Covering 的范式,若存在某个 q 值,对应的 p 极小,此时会产生一个极大的梯度。
DeepSeek V3.2 中做的修复也非常简单,直接加上一个重要性采样即可:
This contrasts sharply with the original K3 estimator, particularly when the sampled tokens have substantially lower probabilities under the current policy than the reference policy, i.e., . In such cases, the gradient of the K3 estimator assigns disproportionately large, unbounded weights to maximize the likelihood of these tokens, resulting in noisy gradient updates that accumulate to degrade sample quality in subsequent iterations and lead to unstable training dynamics.
Off-Policy Sequence Masking
DeepSeek-V3.2 提出的第二项优化,就是针对 GRPO 轮间内部的 off-policy 问题进行的修复。Off-Policy 产生的本质原因就是 用于收集训练数据的行为策略(Behavior Policy)与执行梯度更新时所优化的目标策略(Target Policy)不一致。具体在 LLM-RL 中,往往存在两点的具体表现:
- 一个 Rollout Batch 被拆成多个 Mini-batch 进行梯度更新,随着参数变化,后面的 Mini-batch 越来越 Off-Policy。
- 这一点是 GRPO 原本的算法设计所带来的问题
- Rollout 使用高性能 Inference Engine,而训练使用 Training Engine,二者的数值实现差异也会带来策略不一致。
- 这一点是工程上的问题
因此,DeepSeek 为了缓解训练数据的 off-policy 问题,提出 Sequence-masking 策略:当一条轨迹的 Advantage 为负,并且与当前 Policy 的差异过大时,不再使用这条轨迹更新 Policy, 定义 Sequence Level Divergence:
定义 token-level 的 masking (不过 GRPO 的 sequence 梯度是直接复制 sequence 的梯度,所以这里本质上就是 sequence-level 的 masking,一整条轨迹全部被 mask 不执行梯度更新):
MoE Routing
这个是 MoE 的一个经典问题,哪怕 MoE 在 forward 和 rollout 过程中执行完全相同的 token 序列,也仍然是 off-policy 的,因为可能 router 路由了不同的专家。同时,这样也会导致模型梯度的不稳定现象。
解决方式也非常简单,直接记住对应激活的专家数量,即 rollout 和 forward 的时候激活相同的专家。(这里只是固定 router,但是对应 router 的表现仍然可以被梯度回传计算 loss)
Keep Sampling Mask
Rollout 阶段是需要做 next-toke-prediction 的,但是 training-forward 阶段是不实际产生 token && 和环境进行交互的,因此 rollout 阶段往往使用高性能,高吞吐的推理引擎 (vLLM, sgLang), 但是 training-forward 阶段的 forward 更多是为了做 weight-update 使用。带来的一个问题是: Rollout 阶段常使用 Top-p / Top-k Sampling,但 Training 阶段计算 log probability 时,可能使用没有截断的完整词表分布。
也就是说,在 forward 阶段模型有概率采样出来原本轨迹中被 top-p/k mask 掉的 token,这会导致梯度更新不稳定等问题。(本质原因是这会导致 Importance Sampling Ratio 失效)
DeepSeek 对应的修复仍然是:记录 rollout 阶段对应的 top-p/top-k masking,在 training-forward 阶段保留相同的 action-space,保证一致性。
DAPO
DAPO (https://arxiv.org/pdf/2503.14476) 是字节在 GRPO 基础上实现的一系列改进,同时在 verl 强化学习框架中开源了大规模 RL 训练的代码细节。在 DAPO 中,实现了针对 GRPO 的四个独立优化点:
类似对 GRPO/PPO 的改进其实都是贴膏药式的改进,来解决真实 GRPO 训练中存在的问题。这些工程细节往往是决定 RL 训练能否顺利进行的最后一公里。
首先,DAPO 的算法是用在 RLVR-Math 场景下的,因此去掉了 KL 散度项的约束。
However, during training the long-CoT reasoning model, the model distribution can diverge significantly from the initial model, thus this restriction is not necessary. Therefore, we will exclude the KL term from our proposed algorithm.
接下来,我们来看 DAPO 的全局公式 (Decouple Clip and Dynamic sampling Policy Optimization (DAPO)):
Clip-Higher
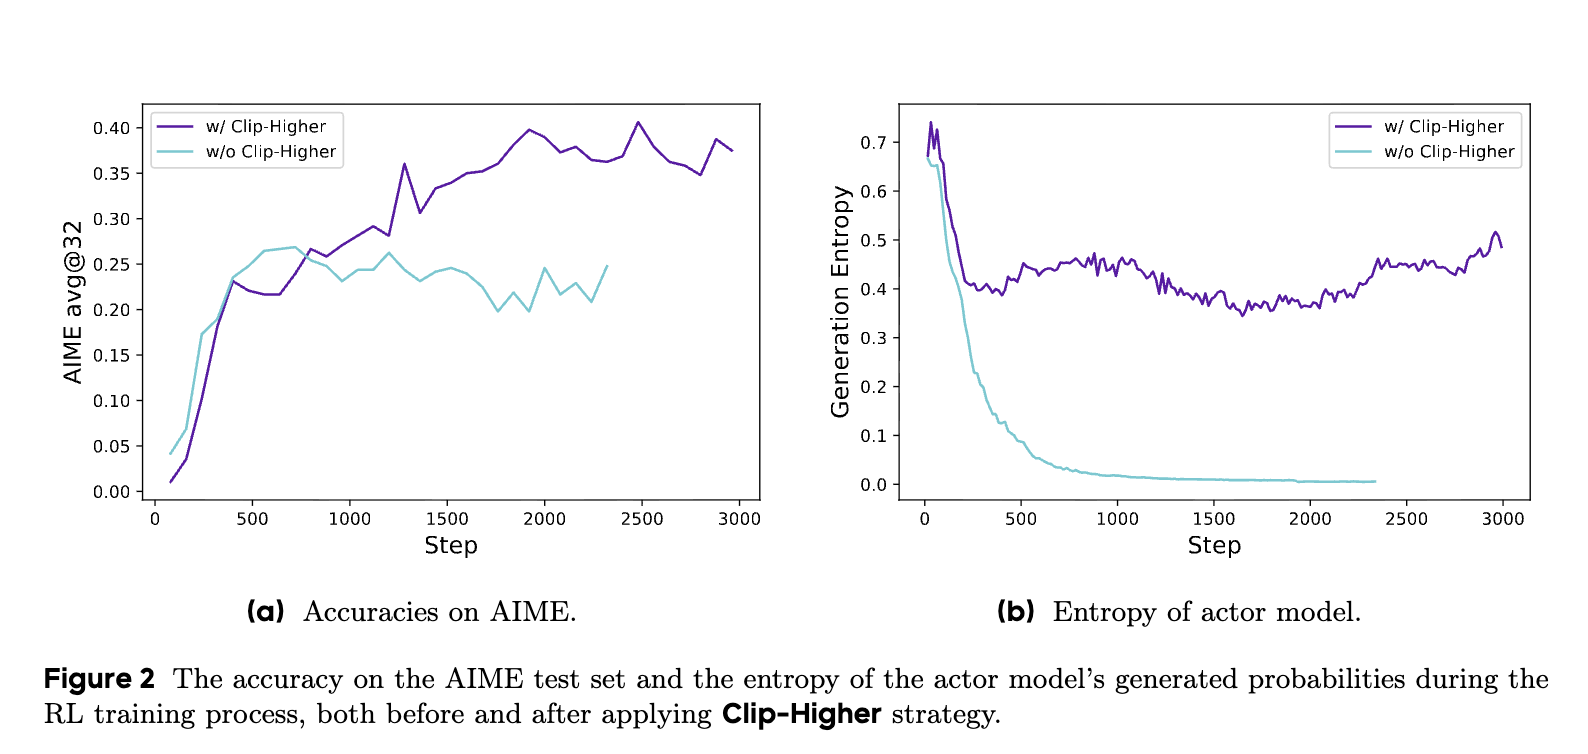
作者发现,在 GRPO 中,随着 RL-Steps 的 Scaling,模型的熵出现了严重的坍缩情况,即发生了 Entropy Collapse:
- 高概率 Token 越来越占优势。
- 低概率但可能有价值的 Token 难以提高概率。
- 生成结果越来越相似,探索能力下降。
作者认为这一现象和模型的 clip 有关,假设上限 clip 是 1.2,当前 :
- 概率是 0.1: 则此时策略若概率大于 0.12,则对应的 advantages 就会 clip,不在进一步产生概率的梯度 -> 高价值的潜在 token 被浪费
- 概率是 0.9: 此时 0.9 * 1.2 > 1, 即此时上界的概率约束实际上是被浪费的 -> 容易导致熵坍缩
DAPO 的优化目标就是,选择不同的上界和下界,上界的值大于下界的值。可以一定程度缓解模型 RL 训练时的收敛问题。(允许他进行更激进的探索)
Dynamic Sampling
对于 RL 训练的环境和数据,模型对不同题目产生的 Advantage 和梯度:
- 过于简单: Reward 全是 0 && 过于难: Reward 全是 1
- 舒适区: 既有 reward=0, 也有 reward=1 的部分 -> 模型可以学习到较好的梯度
因此,Dynamic Sampling 实现了一种 rollout 数据的丢弃: 只保留那些同一组 Rollout 中既有正确答案、又有错误答案的 Prompt。
约束条件为:
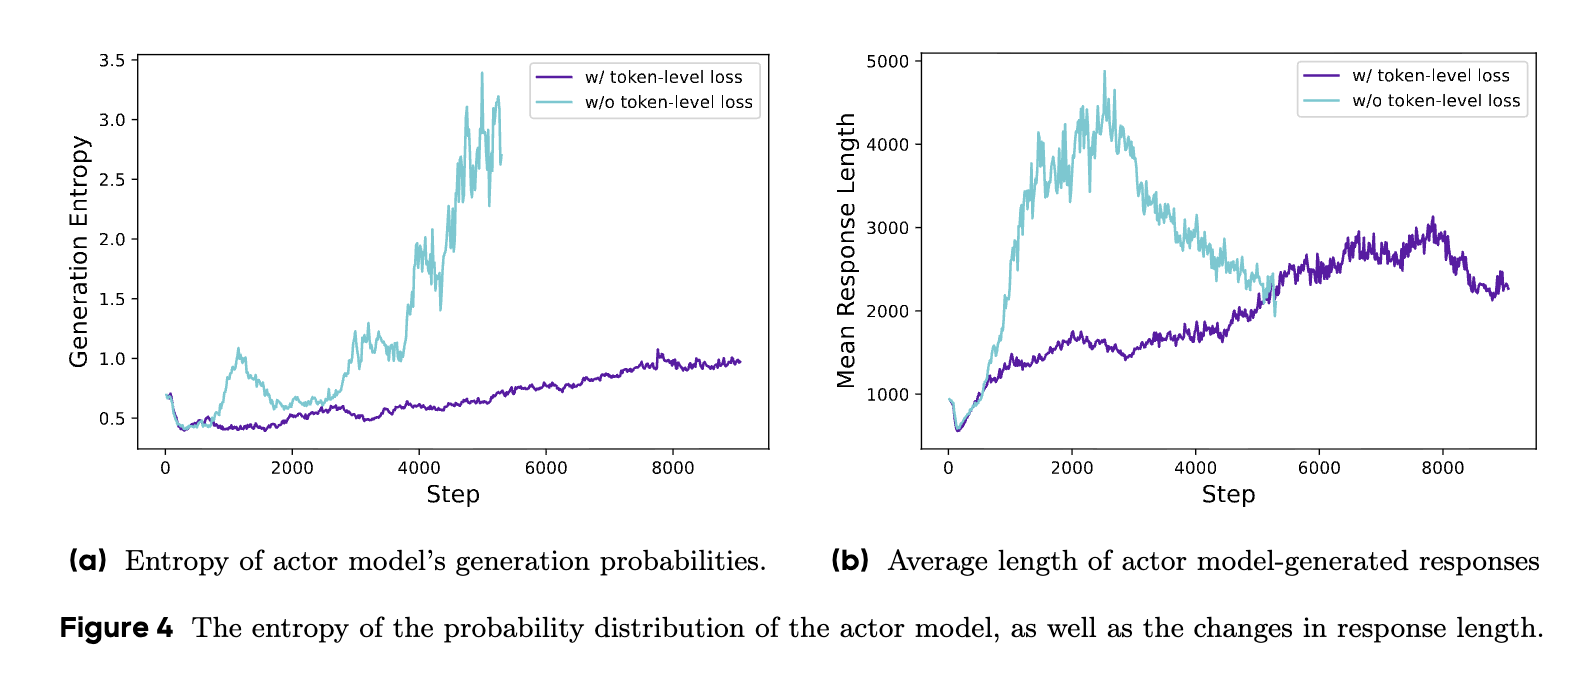
Token-Level Policy Gradient Loss
设一条 Response 有 个 Token,单个 Token 的 Policy Objective 为:
原始 GRPO 先计算每条 Response 的平均 Loss,再对所有 Response 求平均:
这意味着,每条 Response 无论长短,在 Loss Aggregation 中具有相同的总权重。DAPO 直接对整个 Batch 的所有 Token 进行平均:
因此,每个有效 Token 在 Loss Aggregation 中获得相同的权重,而不是每条 Response 获得相同权重。
比如,在原始 GRPO 的计算中,越长轨迹的 token 实际在 loss 中的权重占比会越低。修复这一问题后,不同 token 上 权重分配更加合理。
Overlong Shaping
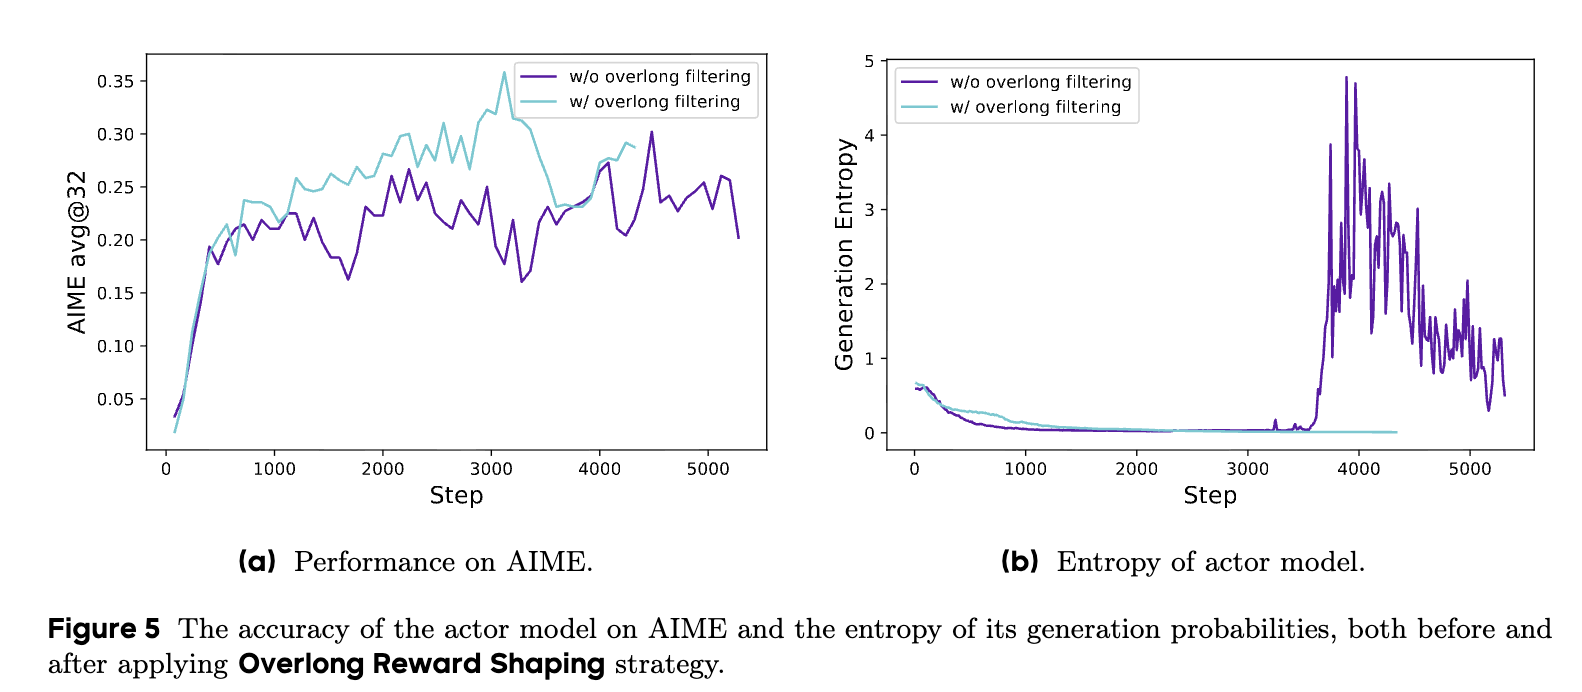
在 Reasoning-RL 中,模型往往因为过长的 reasoning-trace 导致 output-length 截断,对于这种样本,如果直接处理,会处理成 reward=0 的错误回答样本。但是在实际中,“过长截断”和“错误回答”的情况应该被分开处理。
- 首先,截断的回答不应该计算 loss,因为这些回答往往存在突然停止的特征,会干扰正常的模型学习
- 其次,通过引入长度惩罚,保证模型可以简短输出长度:
- 在一个区间内不惩罚,在达到惩罚区间后,提供线性惩罚项直到达到最大惩罚 -1
GSPO
Motivations
我们接下来介绍 GSPO, 是在 2025 年 9 月,由 Qwen 团队提出的一个经典 RL 算法,GSPO 被认为是基于 GRPO 的一项很有效的改进,也在众多的 XXPO 中脱颖而出,形成当前 MoE 大模型训练的 RL 范式之一。
我们首先回顾 GRPO 的核心优化目标:
其中:
注意两个不同的层次:
- Advantage 是 Sequence-Level:一条 Response 中的所有 Token 共享同一个 Advantage。
- 这也是 GRPO 经常被诟病的问题: sequence-level 的 advantage 直接被传递到 token-level 的粒度上
- Importance Ratio 是 Token-Level:每个 Token 单独计算 Ratio,并单独执行 Clipping。
这就意味着,即使所有 Token 获得的奖励信号相同,最终每个 Token 的梯度权重却可能不同。(因为每个 token 的 importance-ratio 不同)。对 token-level 的 监督信号,好处显然是他可以直接作用到每一次 forward 计算的梯度上,直接进行更新,坏处是:这种 Token-Level Ratio 的不均匀性会给训练引入高方差噪声。 特别是 Long-CoT 场景下,Response 包含成千上万个 Token,这种不稳定性可能累积,甚至导致不可逆的 Model Collapse。
因此,Qwen 团队在论文中提出了他们的 Motivation: The above observation suggests a fundamental issue in GRPO’s design. The failure of the token-level importance weight points to a core principle: the unit of optimization objective should match the unit of reward. Since the reward is granted to the entire sequence, applying off-policy correction at the token level appears problematic. This motivates us to forego the token-level objective and explore utilizing importance weights and performing optimization directly at the sequence level.
Methods
我们来看 GSPO 的关键改进: 将原先 token-level 的优化目标换成了 sequence-level 的目标:
和 token-level 的 ratio 比较,sequence-level IS 本质上是一个连乘积的关系,对于自回归模型,一条 Response 的概率为:
展开得到:
但是这会带来一个问题: 对于超长的 sequence, 若干浮点数的连乘积可能会爆炸或者下溢出到 0,导致数值不稳定性。对于这个问题,GSPO 提出的解决方案是,取长度归一化后的作为 :
比如,如果 1000 个 token-ratio 都是 1.01, 加上归一化后(本质是几何平均数),最终得到的 IS 还是 1.01,保证数值稳定性。但是数学上,这样的引入会破坏无偏性。
Token-Level Gradient Analysis
我们可以从第二讲的 Gradient Coefficient 的角度来看 GRPO 和 GSPO 的差异, GRPO 的 GC 是:
注意,这里和第二讲推导的不一样,第二讲的忽略的 off-policy 和 SI 来做简化的假设;这里忽略了 KL 散度的惩罚项和 Clipping
在 GSPO 中,token-level SI 被进一步提前,提到第一个 SUM 号的外面:
因此,GSPO 的 GC 是如下的形式,和 token-t 无关!
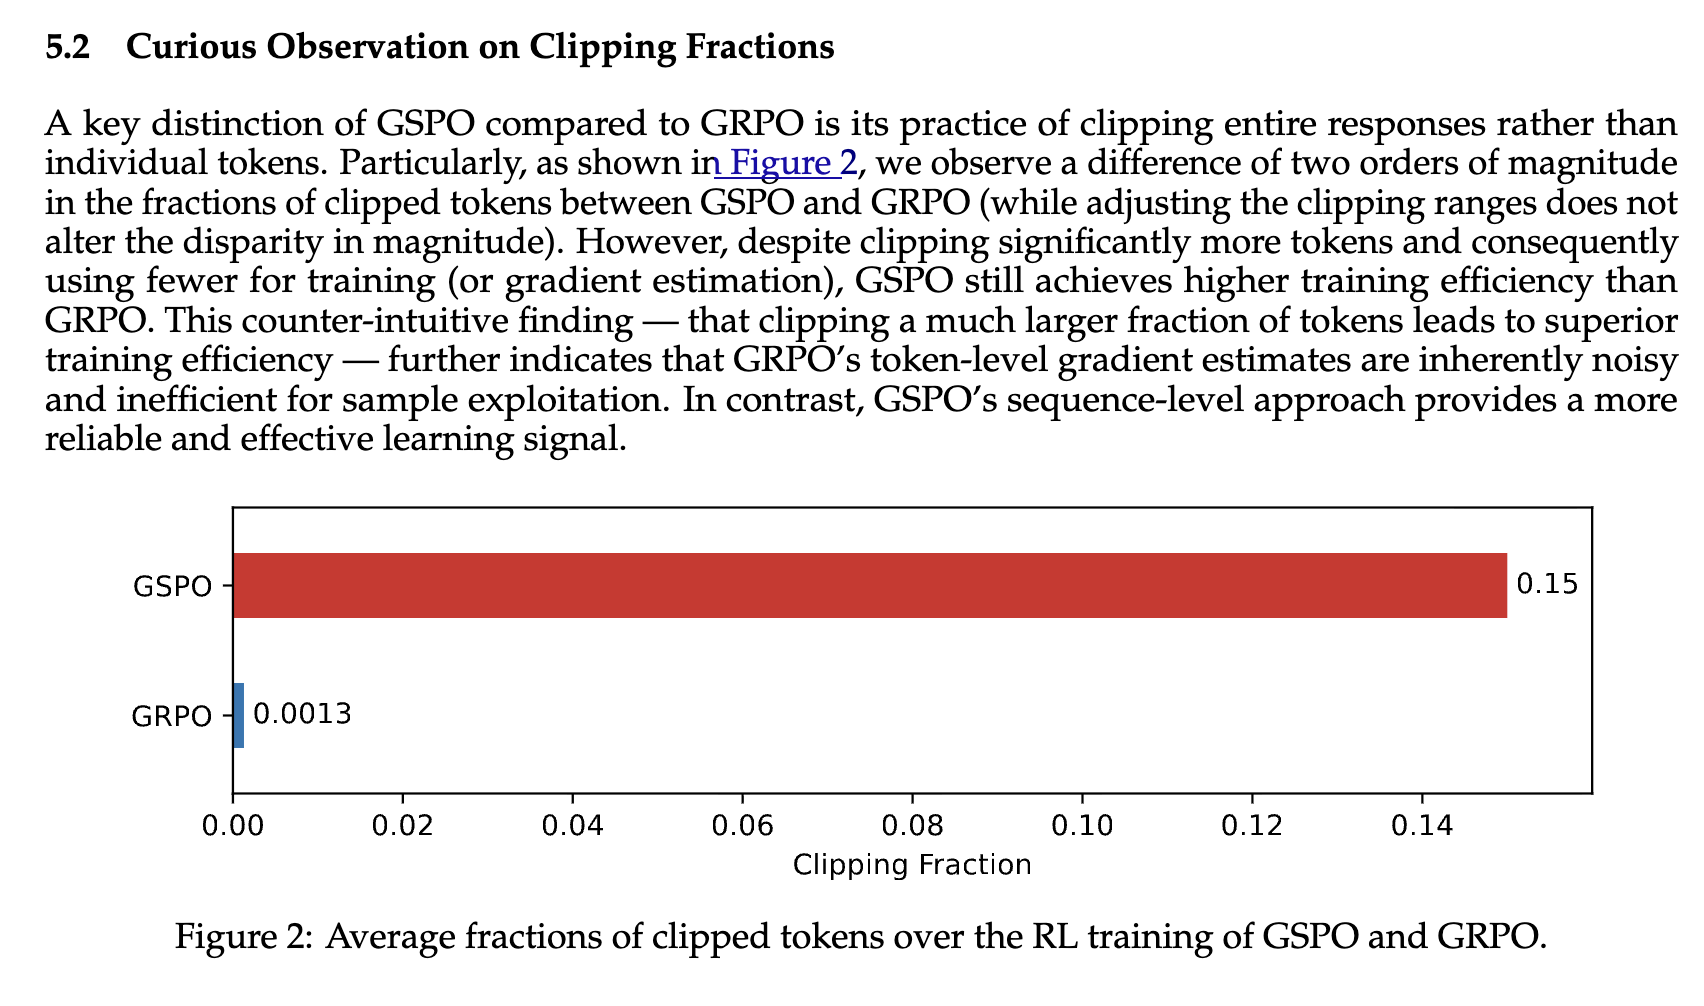
因此,GSPO 在 sequence-level 进行 clipping,会 clip 掉更多的 token, 说明原先 GRPO 保留的 token 很多是无效的训练 token。(fewer gradient contributions, but higher training efficiency)
GSPO in MoE Training & Infra
- Routing Replay 机制 (在 Scaling-GRPO 中被采纳),保证 rollout 和 forward-training 更新和激活的是正确的 FFN Experts
- MoE 的 Expert Routing 变化可能导致个别 Token 的概率发生较大波动,但这些局部波动不一定意味着整条 Response 的概率分布发生了同样剧烈的变化。GSPO 使用 Sequence-Level Ratio,降低了对个别 Token Probability 波动的敏感性。
- 因此,GSPO 不需要使用 Routing Replay 技术 就可以实现稳定的 MoE 训练
同样,在 sequence-level 下,很多原先在 token-level 下训推不一致的问题 (e.g. TITO, rollout engine 的 log-prob 和 forward 的 log-prob 没有对齐)等等问题,都不复存在了。在 sequence-level 上这个问题被解决,更加具备数值稳定性。
GSPO-Token: Back to token-level
在 Multi-turn Agentic-RL 中,sequence-level 会变的极度长尾,此时,直接,可能一条 sequence 本身就包含多个 advantages (即: 如果 advantages 的粒度达到了 token-level, 那 GSPO 本身还应该做什么样的改进?)
因此,作者在 GSPO 基础之上,提出了 GSPO-token:
其中, 的定义为:
sg 代表 stop-gradient,在 PyTorch 中对应 .detach(),即对应项不参与梯度计算,当做常数处理,具体来说,当前项进行 forward 计算时,具体的数值和不加 sg 时保持一致,就是等于 , 但是在反向计算是,detach 不会保留对应的计算图,因此梯度是 ():
我们可以拿这个和原始的 GRPO 进行比较,不考虑 Clipping 时:
代入 GSPO-token 的表达式,对应的梯度可以写为,他的梯度
因此,GSPO-token 相比于 GSPO,只是把 sequence-level 的 advantage 换成了 token-level 的 advantage,但是通过特殊的 Stop Gradient 结构,确保对应的梯度确实作用于相应 Token。
Analysis
我们举一个具体的例子,假设一条 reponse 有两个 token , 对应的 token-level advantage 是 . 假设 sequence-ratio 是 1.1 且没有触发 clipping
如果我们直接把 GSPO 中的 换成 , 即 :
- 计算梯度:
- 他本质上还是在 sequence-level 上做 update,混合了所有的 token-level 的 advantage 的信息,做了一个平均,本质上会影响梯度。
- 注意,这里和 GSPO 的出发点不一样,GSPO 的出发点的希望 IS 这一步做在 sequence-level 上,保证稳定性;但是这里在 sequence-level 上反而混合了每个 token 的 advantage 信号,丢失了信息
- 例如在上面的例子中,advantage 的平均值是 0,此时梯度丢失变成 0
如果我们使用 GSPO-token:
在反向计算时:
第一个 token 得到了正向的梯度增强,第二个 token 得到了梯度抑制!
GSPO-token 可以被认为是一种 GSPO 的强化形式,当 advantage 粒度回退到 sequence-level 的时候,此时 GSPO-token 和 GSPO 在数学形式上等价。
Long-Horizon Agentic RL
GSPO 等 GRPO 的一系列变体,在 RLVR 时代取得了巨大的成功,一系列数学榜单被模型快速攻克。但是,当前的 RL 更多是考验模型的 single-turn reasoning 的能力 (Given , output .),进入 Agentic 时代,涌现出 long-horizon agentic rl,这些需求对算法本身和工程优化提出了更高更难的需求,也是目前学界正在钻研的重点问题之一。我们按照如下的逻辑顺序展开:
- 算法创新:GRPO 还是主流吗?
- SAO: https://arxiv.org/pdf/2607.07508, applied in frontier model training of GLM-5 series.
- FlashReinforcement: https://github.com/yifanzhang-pro/FlashREINFORCE, presented by Nvidia.
- 工程创新: 如何构建一个稳定高效的大型强化学习系统?
- QwenGyre: https://arxiv.org/pdf/2609.33848, applied in frontier model training Qwen-3.8 series. && Mimo V2.6 RL Infra System (https://arxiv.org/pdf/2610.11959)
- Decouple & Schedule: AReal https://github.com/areal-project/AReaL: Pure Async RL 以及其带来的 off-policy bias
- Training-Inference Mismatch problem
- Sandbox Environment InfraStructure (DSec, AgentENV, harbor)
- Training Environment Scaling
RL Scaling 现在是各家基模厂的核心发力点。很多细节性的工程创新将在对应的 Frontier Post Training 章节中详细展开,在本文主要介绍一些极具影响力和代表性的开源工作。