- 在 Input Embedding 上进行 Position Embedding 的嵌入
- 为什么需要位置编码?什么样的位置编码是好的位置编码?
- 对于序列中第 pos 个位置(pos 表示词语在序列中的索引,从 0 开始),其位置编码向量的第 i 个维度(i 表示向量的维度索引)的计算公式
PE(pos,2i)=sin(10000dmodel2ipos)PE(pos,2i+1)=cos(10000dmodel2ipos)- Nomalizations
- Post-Norm(先做 forward 和残差,然后再归一化) && Layer-Norm (对 dmodel 这个维度做归一化)
- FFN
- 使用 RELU 作为激活函数
- FFN(x)=W2max(0,W1x+b1)+b2
在 Attention 那一讲,我们更多探索的是现代大模型架构对 Attention 计算 (Attention Block) 的核心组件的改进和加速,在本文中,我们会思考模型架构中的一些其他组件,看看现代大模型架构相对于传统 Transformers 结构的改进。
在第三讲,我们将会从各家最前沿的技术报告出发,探索下一个时代的前卫的 LLM 架构。
Pre-Norm and Post-Norm#
- Pre-Norm: 先对输入做 Norm 然后再 forward && 做残差连接
- Post-Norm: 先 forward && 做残差连接 再做 Norm
从梯度传递的角度,Pre-Norm 的训练稳定性更好 (xl+1=xl+F(N(xl))) 进行反求梯度会更好 -> 残差项在外面,因此会更稳定
从数学角度诠释:
- PostNorm:
- Forward: xl+1=N(xl+F(xl))
- Backward: ∂xl∂xl+1=JN(I+JF)
- PreNorm:
- Forward: xl+1=xl+F(N(xl))
- Backward: ∂xl∂xl+1=identity pathI+JFJN
从计算稳定性的角度,因为 Pre-Norm 对残差在外面,因此反向传播的时候会更加的稳定
https://arxiv.org/pdf/2002.04745 这篇论文给出了系统性的诠释:
- 对于 PostNorm 的结构,学习率预热非常的重要(在训练初期,学习率线性上升到一个峰值,然后通过各种策略进行 decay)
- Pre-Norm 从理论上和实验上分别证明了其训练稳定性往往高于 Post-Norm
- Post-Norm 需要很谨慎的 learning rate warmup 的过程,稳定性比 Pre-Norm 差
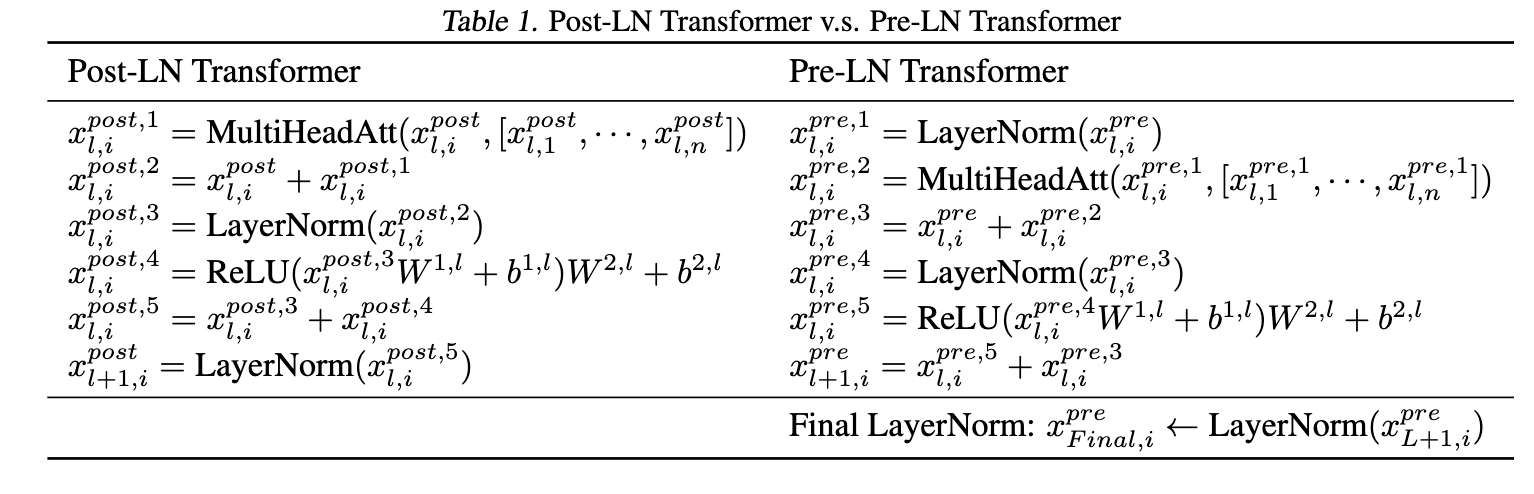
除了标准的 Pre-Norm 和 Post-Norm,还有一些更加高级的操作:
- 传统 Pre-Norm: xl+1=xl+F(Norm(xl))
- Double Norm: xl+1=xl+Norm(F(Norm(xl)))
- Non-residual Post-Norm: xl+1=xl+Norm(F(xl))
RMS Normalizations#
我们主要讨论三种常见的 Norm 计算方式:
- Batch Norm
- Layer Norm
- RMS Norm
Batch Norm#
针对 batch-size 和 length 维度进行归一化,但是因为 LLM 需要处理可变长文本,因此不再采用 Batch Norm
μB=m1k=1∑mxkσB2=m1k=1∑m(xk−μB)2x^i=σB2+ϵxi−μByi=γx^i+βLayer Norm#
μ=d1i=1∑dxiσ2=d1i=1∑d(xi−μ)2x^i=σ2+ϵxi−μyi=γi⊙x^i+βi在传统的 Attention 中,模型的 Norm 使用 LayerNorm 进行优化
RMSNorm#
RMS(x)=d1i=1∑dxi2+ϵx^i=RMS(x)xiyi=γi⊙x^iRMS-Norm 仍然使用 dimension 这个维度进行归一化,同时,RMSNorm 省略了大量的中间变量(不需要计算均值和归一化的均值)
为什么 RMS Norm 的优势显著高于 LayerNorm ?
运算更简单,涉及更少中间变量的存储
激活函数#
激活函数在 FFN 中承担的作用:引入非线性
常见的激活函数:
- sigmoid
- tanh
- relu
- leaky relu
- gelu
- silu/swish
Gated FFNs and SwiGLU#
Gated FFN 在传统 FFN 层上引入了门控机制:
FFN(x)=W2max(0,W1x+b1)+b2h=σ(W1x)对于 Gated FFN:
h=σ(Wgx)⊙(Wux)- Gate Branch 负责提供门控单元,需要过激活函数
- Feature Branch 添加了一个可学习矩阵
SwiGLU:
SiLU(x)=zσ(z)FFNSwiGLU(x)=Wd[SiLU(Wgx)⊙(Wux)]- 激活函数使用 SiLU
- 添加 Gated FFN 同时在外面再套一层可学习矩阵
从参数角度分析,因为引入了一个 gated 参数 Wg,因此参数量会大 3/2 倍。
会考 Rope 的推导 && 模型长度的内推和外推
首先,考虑一个问题,为什么我们需要 Positiom Embedding?因为 transformer 本身的 Attention 不会考虑 position 关系,对 sequence 中的每一个 token 都做同等地位的注意力 attention score 计算。
然后,接下来,我们考虑第二个问题,对于一个 token 在训练 batch 中具备一个编码 i,但是这个 i 不可以按照绝对值的形式直接 append 到一个独立的维度,因为训练的 batch 在实际 inference 的时候,绝对位置可能会发生变化。因此,关注 token间相对位置 是使用 Position Enbedding 最关键的方法。
我们接下来介绍 RoPE 的基本思想,假设当前的 query token 是 qt(Positon: t),当前 token 需要和历史的 s token 进行注意力计算。
- Linear Projections: qt=xtWQ, ks=xsWK
- Position-dependent rotations: qt′=Rtqt, ks′=Rsks
RoPE 需要解决的关键是,Rs, Rt 需要使用什么样矩阵表示?
Rotary Matrix#
(x′y′)=(cosθsinθ−sinθcosθ)(xy)几何意义上,定义上述二维矩阵是 R(θ) 则表示为,在二维空间下按照正方向对向量进行旋转。
旋转矩阵具备如下的性质:
- R(α)T=R(−α)
- R(α)TR(β)=R(β−α)
我们来看看如果我们使用旋转矩阵作为我们的 R, 我们的 attention 计算如下:
qt′=R(t)qt, ks′=R(s)ks,展开 Attention 计算:
(qt′)⊤ks′=(R(t)qt)⊤(R(s)ks)=qt⊤R(t)⊤R(s)ks=qt⊤R(s−t)ks如果我们考虑旋转“角速度”:
(qt′)⊤ks′=(R(t)qt)⊤(R(s)ks)=qt⊤R(t)⊤R(s)ks=qt⊤R(ω(s−t))ks这个式子给了我们一个很有意思的结论:加上 Rope 旋转矩阵后,attention 的计算分数只和两个 token 的相对位置有关,而和绝对位置无关。
对于简单的 Positional Embedding,向量的加法通过 sin 和 cos 实现不同频率的 position 位置的插入,也有类似的性质,但是没有 RoPE 性质那么好。
将二维的旋转矩阵 apply 到高维隐空间中,核心思想是:将高维向量拆分为多个独立的 2 维子空间,并在每个子空间上分别应用不同频率的二维旋转。
对于一个 d 维的向量(假设 d 是偶数),高维旋转矩阵 Rt 可以写成如下形式:
Rt=R(θ1,t)0⋮00R(θ2,t)⋮0⋯⋯⋱⋯00⋮R(θd/2,t)其中:
- 整个矩阵大小为 d×d。
- 对角线上的每一个小块 R(θi,t) 都是一个前面讨论过的 2×2 二维旋转矩阵:
R(θi,t)=(cosθi,tsinθi,t−sinθi,tcosθi,t)
- 每一个 2 维小块的旋转角度 θi,t 是位置 t 与不同频率 ωi 的乘积:θi,t=t⋅ωi。
其中 θi,t 指的是在绝对位置 t 处,针对第 i 个二维子空间的旋转角度。ωi 代表不同 dim 位置上的 rotation,具体的角速度分数和 positional embedding 几乎一致:
ωi=10000−d2(i−1)LLM 会设置一个最大上下文长度 max-content-length, 在 vLLM 等推理引擎进行模型推理时识别这个参数,在监测到长度超过上下文时,会拒绝这一次 LLM-Call 的请求。并且,面对超过预训练长度的请求,模型会因为缺乏对应的训练数据,导致PPL 陡增。
- 外推:直接去让模型处理超过训练长度的 Positional Embedding,但是会导致效果 drop
- 内推 (PI: Positional Interpolation):假设模型训练时的最大上下文长度是 L,当处理超过上下文长度 L′>L 的时候,需要将 L′ 映射到一个在 L 内部的值 L′′(可以是小数)
定义缩放因子 S=L′′L,则上述 Rope 被修正为: θi,t=Stωi,PI 本质上是一种线性内插的方法。
PI 通过固定的缩放因子,可以在推理过程中动态的拉长最大上下文到一个更大的值 (e.g. 拉长 2/4 倍)
NTK-Aware Methods#
https://www.reddit.com/r/LocalLLaMA/comments/14lz7j5/ntkaware_scaled_rope_allows_llama_models_to_have/
在 rope 中,不同位置的旋转矩阵具有不同的频率,低维高频,高维低频。
因此,在线性插值的过程中,会导致低维区域下的旋转变的异常拥挤,会导致效果 drop,可以看到,在低维高频区域,经过线性插值的 PI 和原来的 Rope 存在比较大的差异。
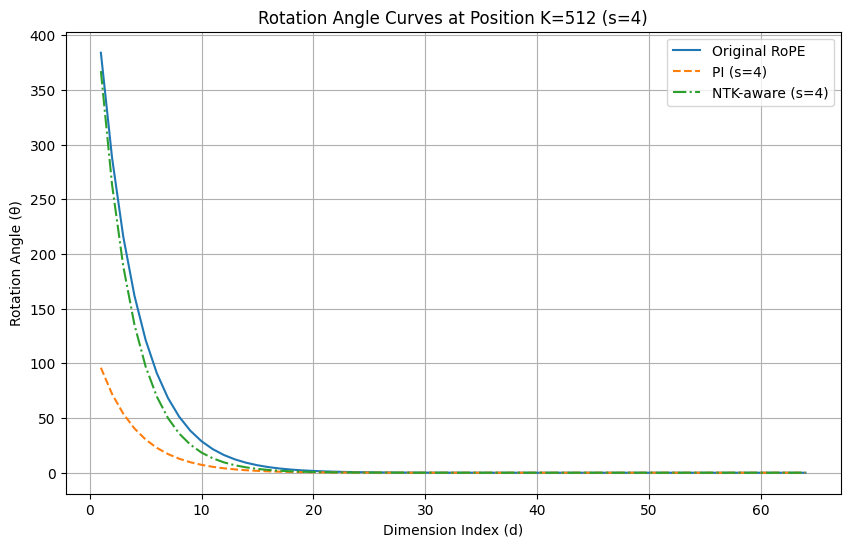
在 PI 中,θ 的格式如下:
(θpi)i,t=St⋅b−d2(i−1)(θNTK)i,t=t⋅(b⋅Sd−2d)−d2(i−1)我们考虑 0-based 计数的 RoPE:
θi,t=t⋅ωi=t⋅b−d2i这个旋转角可以通过 β 进制的角度解释,define β=bd2:
θi,t=t⋅ωi=t⋅b−d2i=βit因此,旋转角本质上就是求位置 t 的 β 进制,现在我们的目的是拉长推理时的最大上下文长度,在保持 dimension 不变的情况下,模型需要对应提升 β :
θi,t=βit/S=(kβ)itk=S−1/i考虑最大维度下的偏差 -> i=d/2−1 -> k=S2/(d−2)
更精彩的诠释可以查看苏老师的博客:https://normxu.github.io/Rethinking-Rotary-Position-Embedding/
同样的,在 NTK-Aware 方法之后,还出现了 NTK-by-parts 等等方法:
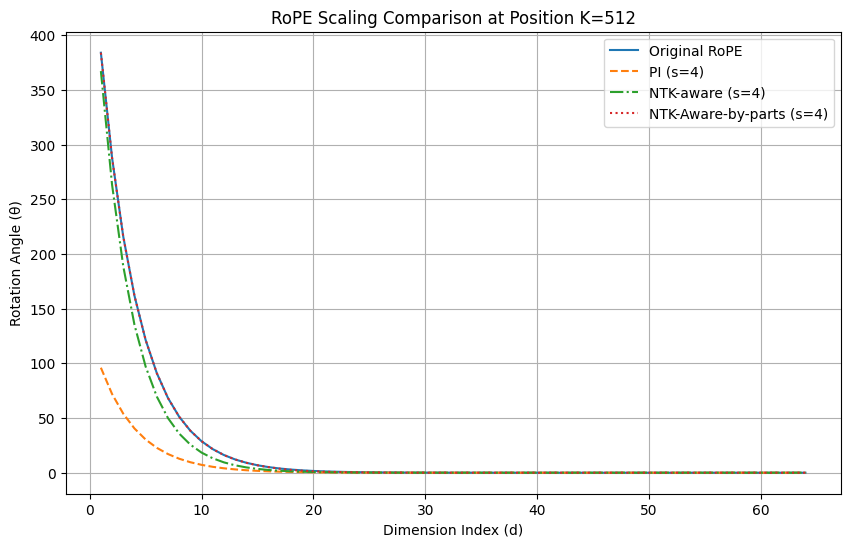
NTK-by-parts 吸收了 NTK 高频和低频的在压缩时不一致的问题,因此引入了一个混合加权的策略,在低维高频区域,不引入任何压缩,在高维低频区域,引入简单的线性插值,中间部分通过滑动加权进行平滑处理。具体的数学公式可以看经典论文 https://arxiv.org/pdf/2309.00071
此外,还有 Dynamic-NTK,只在推理上下文长度超过 L 时引入对应的策略 (PI, NTK-Aware, NTK-Select, YaRN),在正常的上下文长度时,保持为 L 不变。
YaRN#
https://arxiv.org/pdf/2309.00071 是在 NTK-Aware 基础上提出的一种新的拉长模型上下文的方法。
在插值过程中,研究者发现模型因为上下文变长导致 Attention 计算后的 attention score 出现熵增的趋势(因为参与计算的 token 数量变多了)
Yarn 在 Attention 计算时引入了一种退火参数:
Attention(Q,K,V)=softmax(dk⋅tQKT)V在论文中,作者也给出了 t 的最佳取值
t1=0.1⋅ln(s)+1当我们将一个向量乘以一个大于 1 的倍数 k 之后再输入到 Softmax 函数中,输出的概率分布会变得更加“尖锐”(Sharp)——即最大的概率值会更接近 1,而其余较小的概率值会迅速被压低趋近于 0。
这个有点类似于大模型输出时候,对最后一层的词表做 temperature 的 调整,再经过最后的 softmax 操作。如果 temperature 很小的时候,会导致模型 softmax 输出概率变尖锐,导致最终输出文本更趋于确定性。