Introduction
MoE (Mixture of Experts) 的思想在 DeepSeek-V2 (https://arxiv.org/pdf/2405.04434) 中被首次 apply 到百 B 模型的语言模型架构中。
在 Dense FFN 中,模型的 forward path 是 , 而在 Sparse MoE 中, 模型会通过一个 moe router 路由激活不同的专家 , 的参数量和 的参数量相同,MoE 本质上是一种只增加参数量,不增加计算量(稀疏度提升) 的方式。
为什么 MoE 模型具备更高的性能,在实际的 pre-training 中,稀疏的 MoE 模型展现了如下的优势:
- Same Flops,more params perform better (专家数 up) (https://arxiv.org/pdf/2101.03961)
- Faster to train MoEs
- 硬件上天生更容易并行化,更容易 scale up (EP)
MoE 和 Dense 模型相比,在训练 loss 和下游评测基准上均有显著提升,同时 MoE 本身也是一个很值得被讨论的 topic
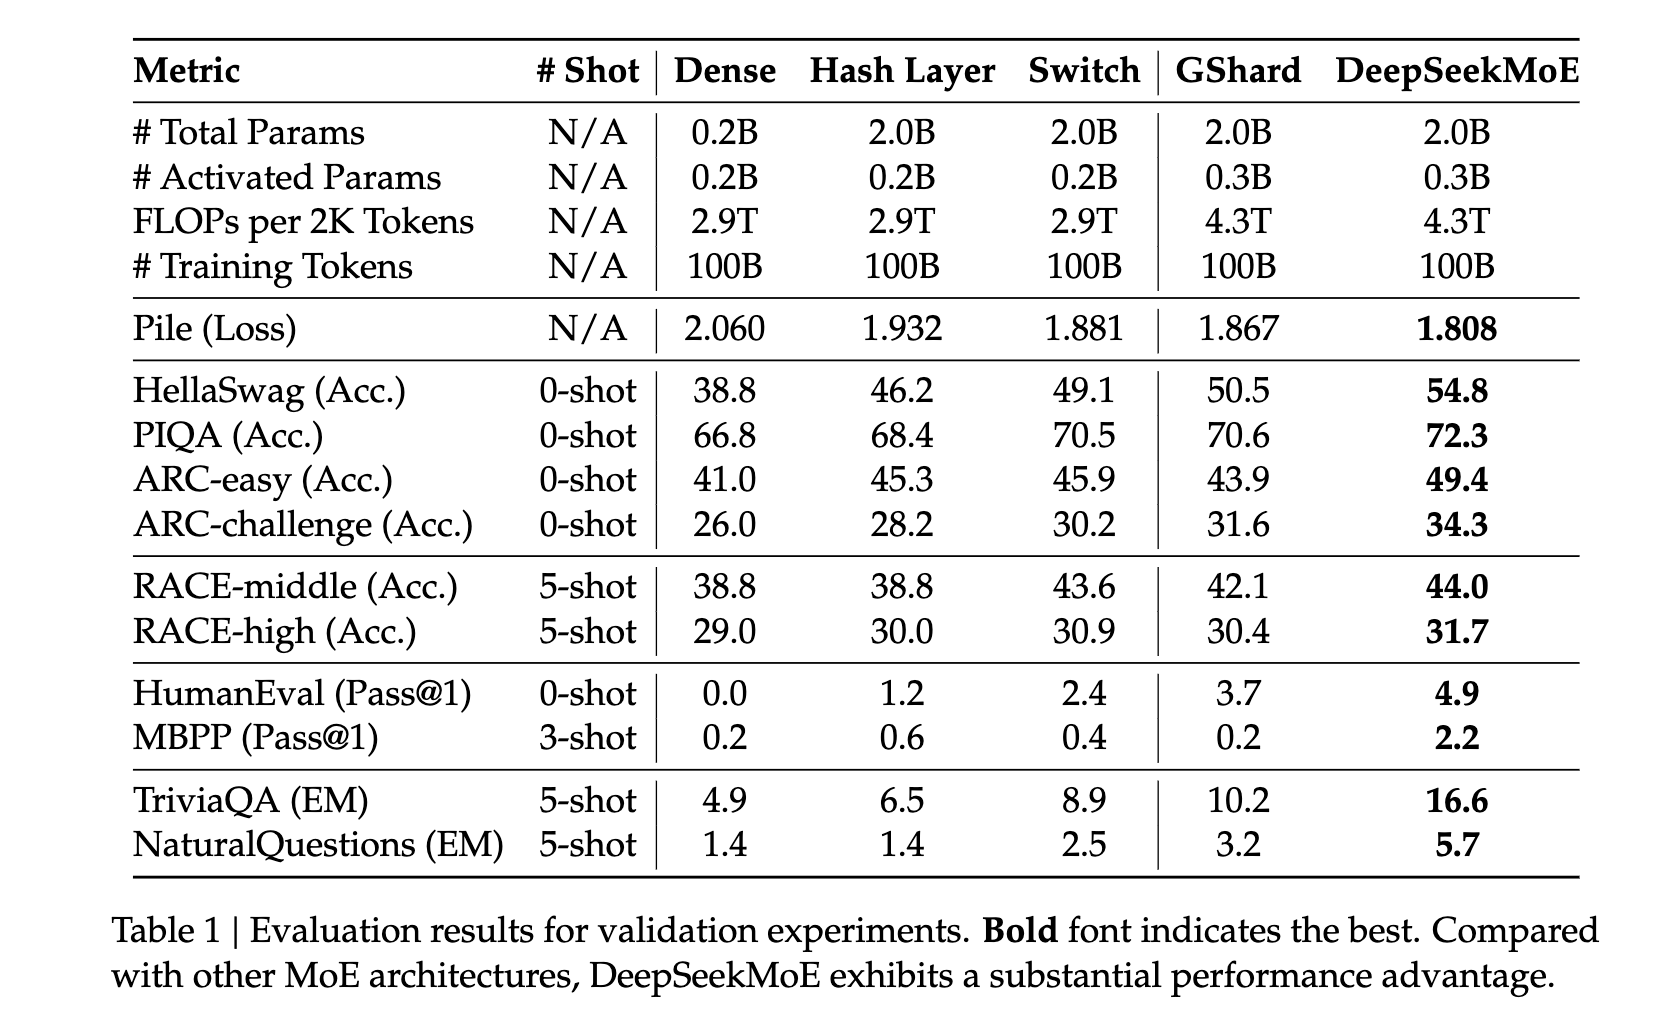
但与此同时,MoE 训练会带来更多工程难题和训练不稳定的问题。
Expert Selections && Expert Weights
在 MoE 架构中,我们要第一个解决的问题是:
- MoE Selection: 针对一个给定的 token,如何选择合适的专家进行激活?
- Experts Weights: 给定激活专家后,如何 aggregate 不同模型的网络输出?
MoE Selections
基本的 MoE 的专家激活 router 都依赖于 Top-K 算法,其中 就是单个 token 传入 FFN Layer 的 hidden-dim 维度是 , 最终输出的是不同专家的激活值 .
对输出的 expert-logits 做 softmax:
专家的激活选择往往依赖 Top-K 方法:
MoE Expert Weights
最终 FFN 前馈网络的输出是多个专家网络的输出加权和,每一个被激活专家的加权值被定义为
在这里存在两种加权方式:
- topk 后不 normalize: 直接利用 softmax 的值作为加权值
- topk 后 normalize:在 softmax 后对选中的 topk 重新归一化 scale 比例,使得最终加权的概率总和为 1,从数学上这个和“先选择 top-k,再对 top-k 做 softmax 等价
Swi Transformer 没有做 normalize,保留 Softmax Probability 作为 Gate Weight(因为每次只激活一个专家),防止 top-1-trap(当某个专家的 weight 超过 0.5 后,模型的输出会被退化为 dense-FFN 的输出形式),导致模型梯度消失。
在更前沿的 MoE router 设计中,更多的数学结构被提出 (e.g. DeepSeek-V3 使用 sigmoid 函数进行 router top-k 计算和加权)
Routing Methods
给定 Expert Logits 如何选择激活的专家?
- TopK routing (k = 1,2,4,7...)
- Hashing (baseline, 随机选择)
- RL learning (like a Bandit Problem)
- Solving a matching problem
Expert Sizes
一个系统架构上设计很经典的问题是:设计多少个专家?(总参数量),每次前向计算激活多少专家?(稀疏度,激活参数量)
假设有 个专家(激活 个专家),每个专家的参数量是 , FFN 的总参数量就是 .
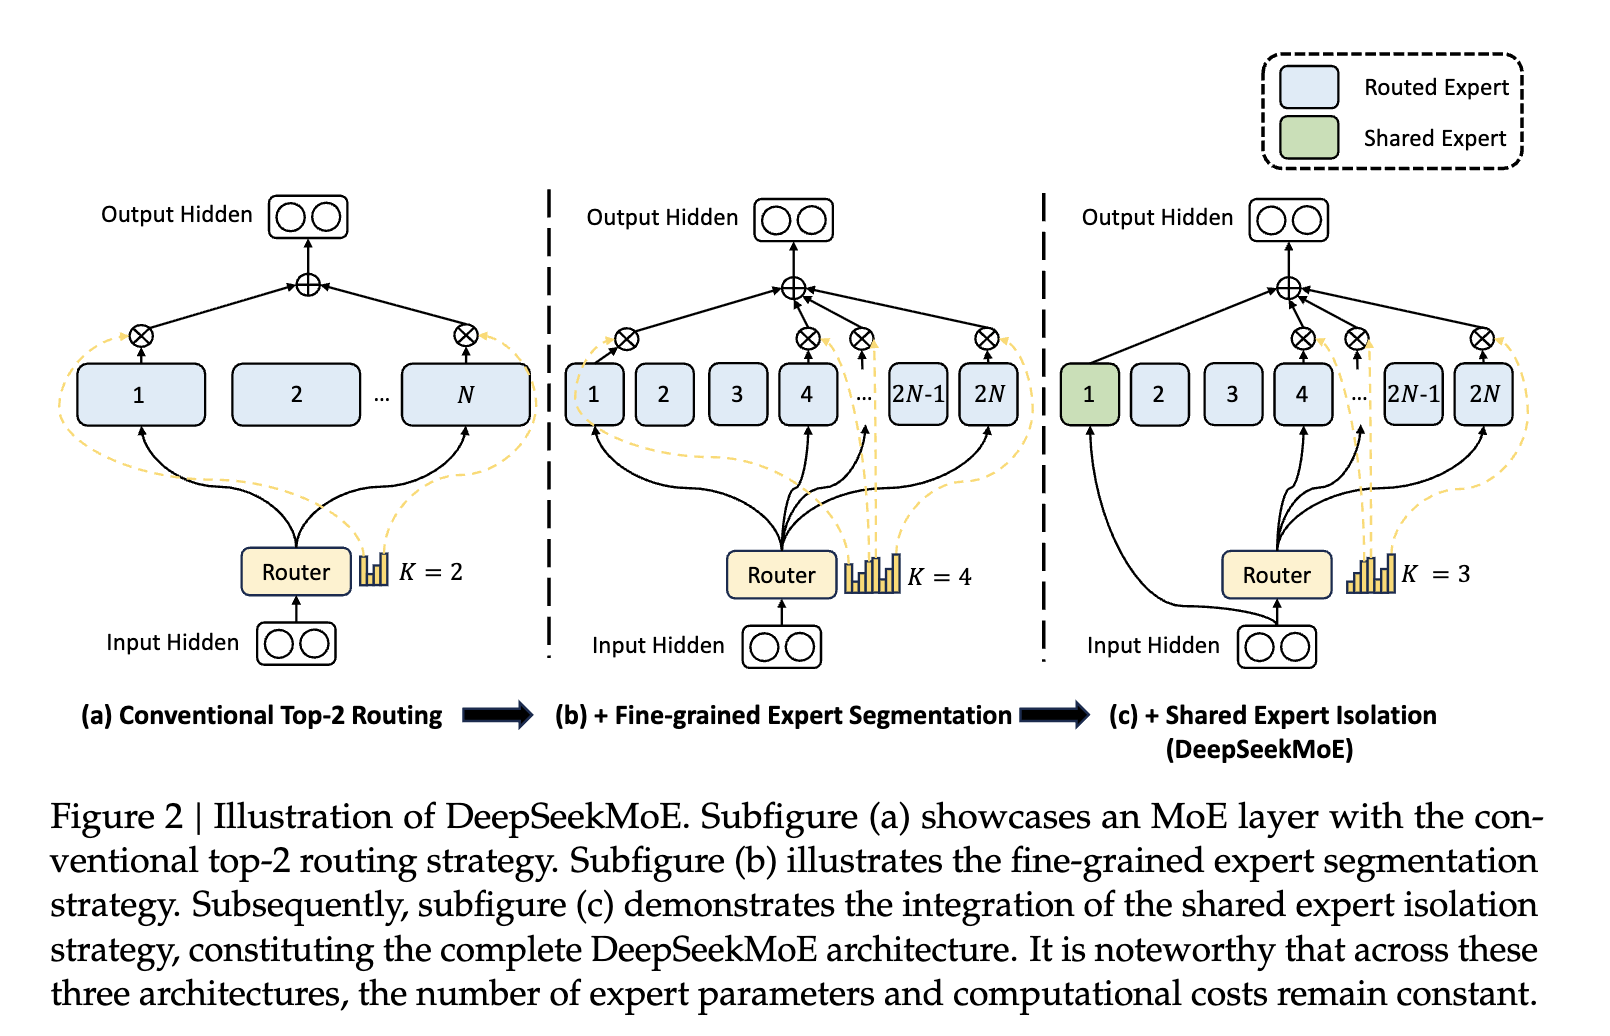
此时,我们可以选择提升专家的数量,减少每个专家的激活参数,此时,专家总数和激活专家数量变成 和 , 每个专家的参数量是 ,模型的总参数和稀疏度都不变!实验验证提升专家数量可以在不提升稀疏度和参数的情况下提升 MoE 的性能,但是切分过细的专家也会对 router 负载均衡和训练稳定性提出更高的要求,且切分过细的专家也会损失表征能力。
这种技术被叫做 fine-grained expert segmentations, 在 DeepSeek MoE 的技术报告中被提及:
From a combinatorial perspective, the fine-grained expert segmentation strategy substantially enhances the combinatorial flexibility of activated expert. (提升专家的表征能力)
一些比较前沿和经典的 MoE 参数配置:
| 模型 | 总量 / 激活 | 参数比 | Routed / K / Shared | 专家比 |
|---|---|---|---|---|
| Qwen-series | ||||
| Qwen3-30B-A3B | 30 / 3B | 10.0× | 128 / 8 / 0 | 16× |
| Qwen3-235B-A22B | 235 / 22B | 10.7× | 128 / 8 / 0 | 16× |
| Qwen3-Coder-480B-A35B | 480 / 35B | 13.7× | 160 / 8 / 0 | 20× |
| Qwen3-Next-80B-A3B | 80 / 3B | 26.7× | 512 / 10 / 1 | 51.2× |
| Qwen3.5-35B-A3B | 35 / 3B | 11.7× | 256 / 8 / 1 | 32× |
| Qwen3.5-122B-A10B | 122 / 10B | 12.2× | 256 / 8 / 1 | 32× |
| Qwen3.5-397B-A17B | 397 / 17B | 23.4× | 512 / 10 / 1 | 51.2× |
| Qwen3.8-2.4T-A95B | 2400 / 95B | 25.3× | 512 / 10 / 1 | 51.2× |
| Qwen3.8-Flash-Next-176B | 125 / 6B | 20.8x | 512 / 10 / 1 | 51.2x |
| GLM-series | ||||
| GLM-4.5-Air | 106 / 12B | 8.8× | 128 / 8 / 1 | 16× |
| GLM-4.5 | 355 / 32B | 11.1× | 160 / 8 / 1 | 20× |
| GLM-4.7 | ≈358 / 32B | ≈11.2× | 160 / 8 / 1 | 20× |
| GLM-4.7-Flash | 30 / 3B | 10.0× | 64 / 4 / 1 | 16× |
| GLM-5 / 5.1 / 5.2 | 744 / 40B | 18.6× | 256 / 8 / 1 | 32× |
| GLM-5.3 | ≈744 / 40B | ≈18.6× | 256 / 8 / 1 | 32× |
| GLM-5.3-Flash | 320 / 18B | 17.8× | 288 / 8 / 1 | 36× |
| Kimi | ||||
| Kimi-K2 | ≈1000 / 32B | ≈31.3× | 384 / 8 / 1 | 48× |
| Kimi-K2.5 / K2.6 | ≈1000 / 32B | ≈31.3× | 384 / 8 / 1 | 48× |
| Kimi-K3 | 2800 / 104B | 26.9× | 896 / 16 / 2 | 56× |
| MiniMax | ||||
| MiniMax-M2 | 230 / 10B | 23.0× | 256 / 8 / 0 | 32× |
| MiniMax-M2.5 | 230 / 10B | 23.0× | 256 / 8 / 0 | 32× |
| MiniMax-M3 | 428 / 23B | 18.6× | 128 / 4 / 1 | 32× |
| DeepSeek | ||||
| DeepSeek-V3 | 671 / 37B | 18.1× | 256 / 8 / 1 | 32× |
| DeepSeek-R1 | 671 / 37B | 18.1× | 256 / 8 / 1 | 32× |
| DeepSeek-R1-0528 | 671 / 37B | 18.1× | 256 / 8 / 1 | 32× |
| DeepSeek-V3.2 | 671 / 37B | 18.1× | 256 / 8 / 1 | 32× |
| DeepSeek-V4-Flash | 284 / 13B | 21.8× | 256 / 6 / 1 | 42.7× |
| DeepSeek-V4-Pro | 1.6 / 49B | 32.7× | 384 / 6 / 1 | 64× |
| Other | ||||
| Hunyuan-A13B | 80 / 13B | 6.2× | 64 / 8 / 1 | 8× |
| Tencent Hy3 | 295 / 21B | 14.0× | 192 / 8 / 1 | 24× |
| Xiaomi MiMo-V2-Flash | 309 / 15B | 20.6× | 256 / 8 / 0 | 32× |
| Step3.5-Flash | 196 / 11B | 17.8× | 288 / 8 / 1 | 36× |
| OpenAI gpt-oss-120b | 117 / 5.1B | 22.9× | 128 / 4 / 0 | 32× |
| OpenAI gpt-oss-20b | 21 / 3.6B | 5.8× | 32 / 4 / 0 | 8× |
- 从专家激活数量上,现代大模型的稀疏度都在不断上升 (专家数量稀疏度)
MoE Trainings
在 MoE 训练中,Training Objective:
- 第一项是语言建模的二进制交叉熵损失
- 第二项是专家激活的负载均衡
- 第三项是针对 output logits 的数值约束,保证 logits 的输出是一个比较温和的值
LM Loss
在前向计算是, 计算流程图是:
因此,计算反向传播,定义: :
- 代表 loss 变化最快的方向
- 代表当前激活专家和最终输出的偏移
因此,从反向传播的角度分析,若每个专家的激活值可以更好的帮助 loss 下降,这个专家的 router 就会在梯度下降上体现 increase
Load Balancing
第二项 MoE 训练的 Loss,是 load balancing,也是 MoE 训练中最关键的问题:
- : 实际分配比例 每个专家分配到的 token 数量占比
- : Router 分配给 Expert 的平均概率
| Token | Selected Experts | ||||
|---|---|---|---|---|---|
| 1 | 0.60 | 0.25 | 0.10 | 0.05 | |
| 2 | 0.50 | 0.10 | 0.35 | 0.05 | |
| 3 | 0.40 | 0.20 | 0.35 | 0.05 | |
| 4 | 0.10 | 0.45 | 0.20 | 0.25 |
T = 4, N = 4 and K = 2
- 对应的 就看每一个专家对应 route 到 token 的概率
- 是一个统计量
在实际反向传播中,针对 进行反向传播, . 当此时某个专家已经具备了很高的负载 值时,进一步增加概率(对应增加未来负载)会导致负载 loss 进一步增大。反而,转向一些被闲置的 expert 可以保证 loss 下降。
最小化的理想条件: 均为 (柯西不等式可以证明)
Logits Stability
对输出的 expert-logits 做 softmax:
我们可以证明, 进行同加减,对应的 值不变, Define :
因此:
我们希望 logits 输出侧就保证数值稳定性,而不依赖对应的 stable-softmax 等数值优化手段,因此,我们的优化目标定义为 的最小化,或者说,我们希望数值稳定性可以直接保证 。
因此,我们定义针对 项的损失:
注意, logits stability 和 load balancing 是两个完全正交的优化维度,logits stability 可以被优化到 loss=0,但是不等于一定负载均衡。
More About Load Balancing
Stochastic Approximations
在实际模型的 pre-training 中,MoE 的稀疏性使得模型的反向传播不可导,且前向计算每次有可能激活不同的 experts 导致训练不稳定。
类似于 RL 中的 , 在 MoE routing 中引入随机扰动:
这可以在专家激活时引入随机性,一方面保证在训练过程中尽可能负载均衡更多的专家,另一方面,梯度进行反向传播,也更有利于 router 的训练。
Heuristic balancing losses
在原始的 loss 上做 MoE Training,会导致不同专家负载不均衡,更强势的专家获得更好的梯度反馈,被优化的更好,同时 router 也会提升选择当前专家的概率。
因此,现在普遍被采纳的方式是通过 启发式设计的方式在 loss 中引入平衡项,保证 MoE 训练负载均衡。
DeepSeek V2: Per-Expert/Device Balancing
在上文的一般形式中,我们推导了 expert-load-balancing 的基本形式:
DeepSeek-MoE/DeepSeek-V2 采用了两种不同粒度的负载均衡损失:
- Per-Expert Balancing(专家级负载均衡):希望不同 Expert 接收到的 token 数量尽量均衡。
- 代表实际进入不同专家的 token 数量 - 代表 router 对 token 平均而言,router 对当前专家的激活概率输出
因为 TopK 不是一个可以微分的算子,因此损失项没有引入 topk 等相关算符操作
- Per-Device Balancing(设备级负载均衡):希望不同 GPU 上的计算负载尽量均衡。
- 代表实际进入不同设备的 token 数量(device-level 的专家负载)
- 代表Router 分配给设备 上所有专家的总概率质量
两者的数学关系是:
在 DeepSeek V2 中,对 MoE 模型的训练还额外引入了 device-limited routing mechanism,因为 MoE 专家的数量被切割的非常多,因此 Expert Parallelism 的通信成本会非常大。
For DeepSeek-V2, beyond the naive top-K selection of routed experts, we additionally ensure that the target experts of each token will be distributed on at most 𝑀 devices. To be specific, for each token, we first select 𝑀 devices that have experts with the highest affinity scores in them. Then, we perform top-K selection among experts on these 𝑀 devices. In practice, we find that when ⩾ 3, the device-limited routing can achieve a good performance roughly aligned with the unrestricted top-K routing.
与此同时,DeepSeek-V2 的 MoE 训练引入了 Communication Balance Loss:
- 代表设备 对应的通信负载
- 每一个 token 若存在对当前设备 的通信,则会被计入通信负载中,然后除以通信负载的最大设备限制
- 在负载均衡的情况下,每一个设备的通信负载约等于 1