Attention 普遍被认为是语言模型架构的基础,然而,从过去的机器翻译的 Encoder-Decoder 架构到如今的大语言模型,Attention 也出现了大量的变体,用于适配更高效,更 scaleble 的模型。
在今天的内容中,我们将重点介绍常见的 Attention 变体定式,从数学原理到一线的技术报告。
Simple Attentions and MHA
TLDR: 在 Attention is all you need 中,作者提出了最基本的注意力机制和多头注意力的版本。
我们首先看最基本的 Attention 长什么样子, 从最经典的 Attention is all you need 1 开始讲起:
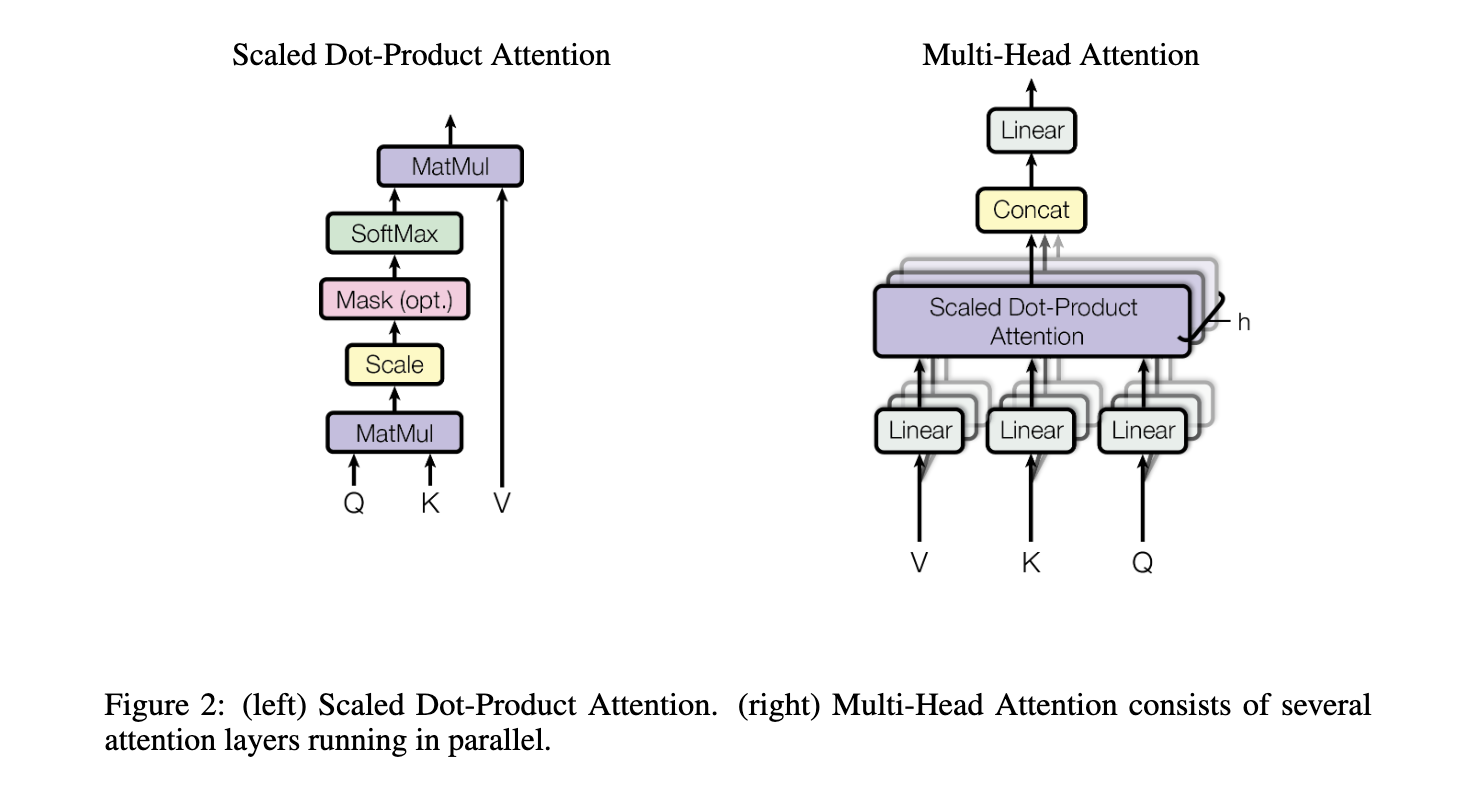
图片左侧救赎最基本的 Attention,他的数学表达形式如下:
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$$Q \in \mathbb{R}^{n \times d_k}$:查询矩阵(Query)
$K \in \mathbb{R}^{m \times d_k}$:键矩阵(Key)
$V \in \mathbb{R}^{m \times d_v}$:值矩阵(Value)
$d_k$:键/查询的向量维度,$\sqrt{d_k}$ 用于防止点积数值过大导致 Softmax 梯度消失
在实际自回归训练中,模型训练不可以看到未来的词,因此需要加上一个掩码矩阵
$$\text{AttentionScore} = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}} + M\right)$$一方面可以避免自回归的时候,未来的词被关注(此时对应的值被掩码成负无穷,softmax 后就是 0),另一方面可以高效的处理被 padding 的词,对应一个 batch 中长短不一的样本。
Multi-Head Attention (MHA)
在 Attention is all you need 的原文中,作者就提出了 MHA(见上图)
MHA 通过将 $Q, K, V$ 投影到多个不同的低维子空间并行计算 Attention,再将结果拼接融合:
$$\text{MHA}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)W^O$$$$\text{其中 } \text{head}_i = \text{Attention}(QW_i^Q, KW_i^K, VW_i^V)$$- $h$:注意力头的数量
- $W_i^Q \in \mathbb{R}^{d_{model} \times d_k}$、$W_i^K \in \mathbb{R}^{d_{model} \times d_k}$、$W_i^V \in \mathbb{R}^{d_{model} \times d_v}$:第 $i$ 个头的投影权重矩阵
- $W^O \in \mathbb{R}^{h d_v \times d_{model}}$:多头拼接后的输出线性变换矩阵(通常设 $h d_k = h d_v = d_{model}$)
具体来说,MHA 进行了一个 低维度子空间压缩 的操作,具体参数:
- $h = 8$, $d_k = d_v = d_{\text{model}}/h = 64$
Decoding-Stage Optimization for Attentions
TLDR: 原始版本的 Transformer 存在 FLOPS 时间复杂度高 && KV 缓存占用率高的问题,后续的 MQA,GQA,MLA 都是在 MHA 的基础上添加各种组件,尝试在不导致性能下降的前提下,从架构上进行KV 缓存的压缩。
在大模型自回归生成时,主要包含两个阶段:
- Prefill:处理输入提示词(Prompt)。这个阶段是计算密集型(Compute-bound),大量并行矩阵乘法主要消耗 GPU 的算力(Tensor Core)
- Decode:逐个生成新的 Token(自回归生成)。这个阶段是访存密集型(Memory-bandwidth-bound)。每生成一个新 Token,GPU 都需要把之前所有历史 Token 的 KV 缓存(Key-Value Cache) 从显存(HBM)加载到计算单元中,这导致显存带宽成为巨大瓶颈。
不同的 Attention 改进都是在 Prefill 或者 Decode 阶段进行加速优化的,例如:
- MQA, GQA, MLA 等方法通过减少 KV-Cache 利用率,提升模型 decoding 的速度
- Sparse Attention 通过稀疏注意力机制,加速 Prefiling 的速度
MQA (Multi-Query Attention) and GQA (Group-Query Attention)
Complexity and KV-Cache
在介绍新的 Attention 之前,我们需要计算 Multi-Head Attention 的时间复杂度:
考虑对于长度为 $N$、特征维度为 $D$ ($d_{model}$) 的输入序列 $X \in \mathbb{R}^{N \times D}$,他会经过如下的计算过程:
- 线性投影得到 QKV 矩阵
- 每一个矩阵的维度: $(N \times D) \times (D \times D)$ 的计算量为:$O(N \cdot D^2)$ -> $6ND^2$
- QK 矩阵相乘
- $(N \times D) \times (D \times N)$: $O(N^2 \cdot D)$
- Softmax 操作不是主要耗时项
- 一个 $(N \times N)$ 的矩阵 和 $(N \times D)$ 的矩阵相乘
- $O(N^2 \cdot D)$
因此,单头注意力的时间复杂度对 N 和 D 都是平方 scale 的,但是因为对 D 来说,往往是一个固定不动的超参数,因此我们可以说,单头注意力的时间复杂度为 $O(N^2)$
对于维度为 $N \times D$ 的矩阵与维度为 $D \times D$ 的矩阵相乘,计算所需的乘法和加法运算次数如下: 乘法运算次数:$N \times D^2$ 次 加法运算次数:$N \times D \times (D - 1)$ 次 总浮点运算次数(FLOPs):$2ND^2 - ND$ 次
多头注意力的本质就是 Attention 的计算在低维子空间中完成,不会带来复杂度级别的额外运算开销,因此仍然是 $O(N^2)$ 的时间复杂度。
这显然是一种无法忍受的开销运算,在自回归的每一次运算过程中,模型都需要忍受 $O(N^2)$ 的运算开销,因此,出现了一种 空间换取时间 的做法: KV-Cache
KV-Cache 是一种缓存技术,其核心在于在自回归生成过程中,缓存关键的历史信息,使得模型只需要针对新输入的 input 向量进行 attention-score 的计算:
- 输入新向量
- 模型的输入是一个向量 $x_N$,进行向量和矩阵的乘法 $q_N = x_N \cdot W_Q$
- 对应生成额外的 $k_N$, $v_N$ 向量
- 更新 KV-Cache
- $$K_{1:N} = \text{Concat}\Big(K_{1:N-1}, \, k_N\Big) \quad \in \mathbb{R}^{N \times D}$$
- $$V_{1:N} = \text{Concat}\Big(V_{1:N-1}, \, v_N\Big) \quad \in \mathbb{R}^{N \times D}$$
- 计算注意力权重时,只需要额外计算 当前新 token 对历史 token 的注意力权重,仍然是一个向量乘矩阵的形式
- $$\text{Score}_N = \frac{q_N \cdot (K_{1:N})^T}{\sqrt{d_k}} \quad \in \mathbb{R}^{1 \times N}$$
- $$\text{Attn\_Weight}_N = \text{Softmax}(\text{Score}_N) \quad \in \mathbb{R}^{1 \times N}$$
- $$\text{Output}_N = \text{Attn\_Weight}_N \cdot V_{1:N} \quad \in \mathbb{R}^{1 \times D}$$
因此,对于一个长度为 $D \times N$ 的输入矩阵,如果使用 KV-Cache 的方式,可以保证全局的复杂度仍然为 $O(N^2)$,但是代价是需要缓存 $K_{1:N-1}$ 和 $V_{1:N-1}$ 两个大矩阵 ($\mathbb{R}^{N \times D}$)
MQA and GQA
显然,如此大的 KV-Cache 和计算复杂度仍然是不可以接受的,因此,一些面向 加速优化 的 Attention 改进开始出现,或者说,加速优化的架构改进仍然是当前 Attention 优化的最关键的 Motivation 之一。
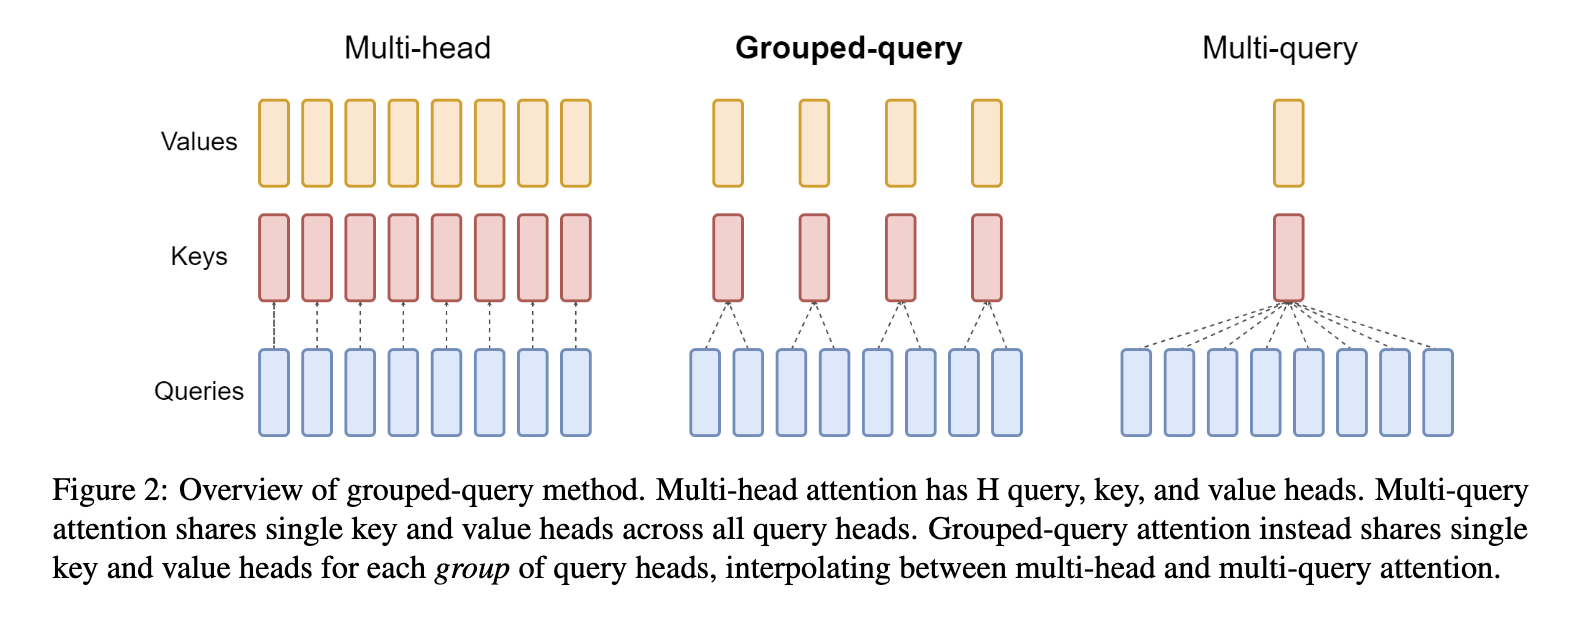
MQA 就是在这个基础上的改进,在 MHA 中,Q, K, V 矩阵会被投影到不同的低维子空间中,因此,每一个子空间下的 KV 矩阵都要被缓存,MQA 的改进是 只投影不同的Query 到子空间,KV 缓存共用相同的部分,可以极大的加速缓存利用效率。
GQA 仍然是在这个基础上做的改进,引入 Grouped Query,可以实现性能和缓存效率的权衡。2
MLA (MultiHead Latent Attentions)
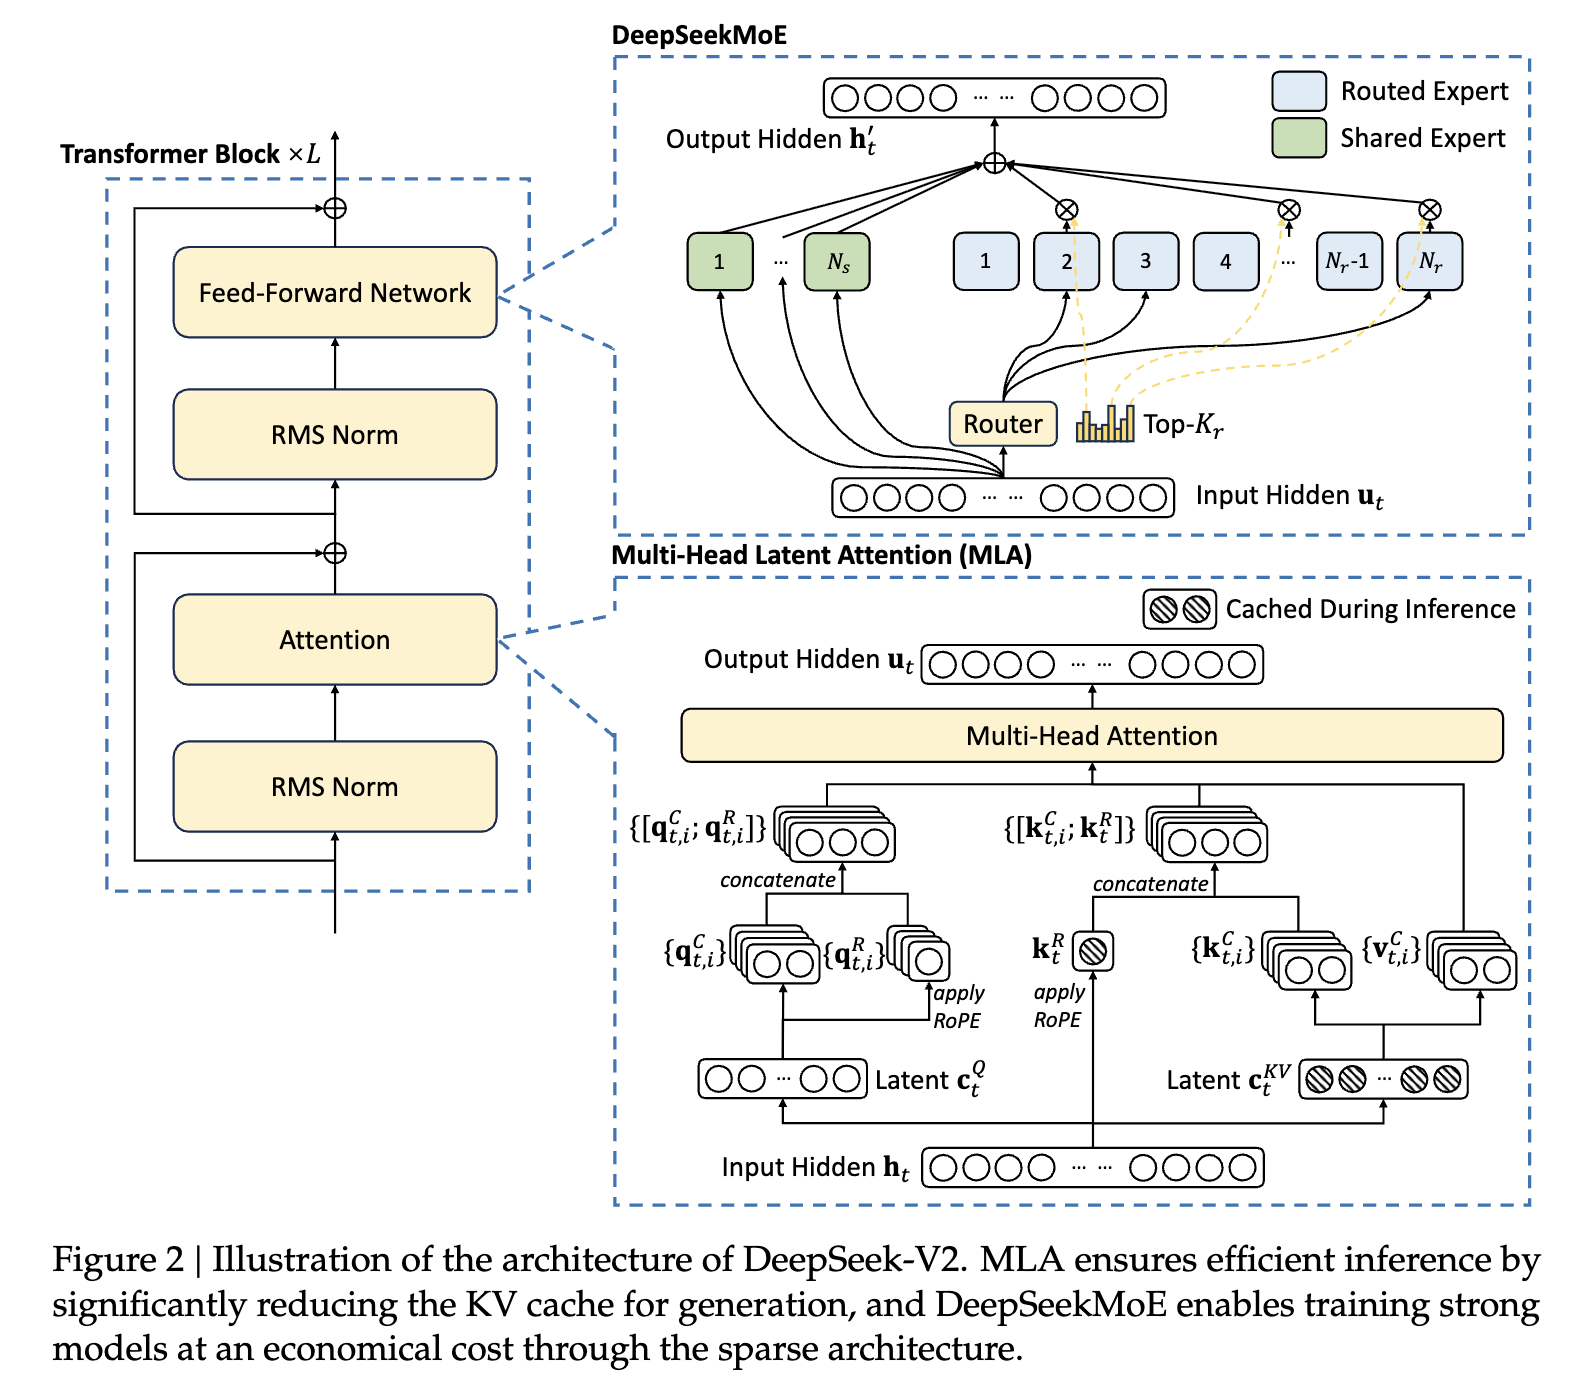
DeepSeek-V2 提出了一种新的 Attention 机制 3, 叫做 Multihead Latent Attention。
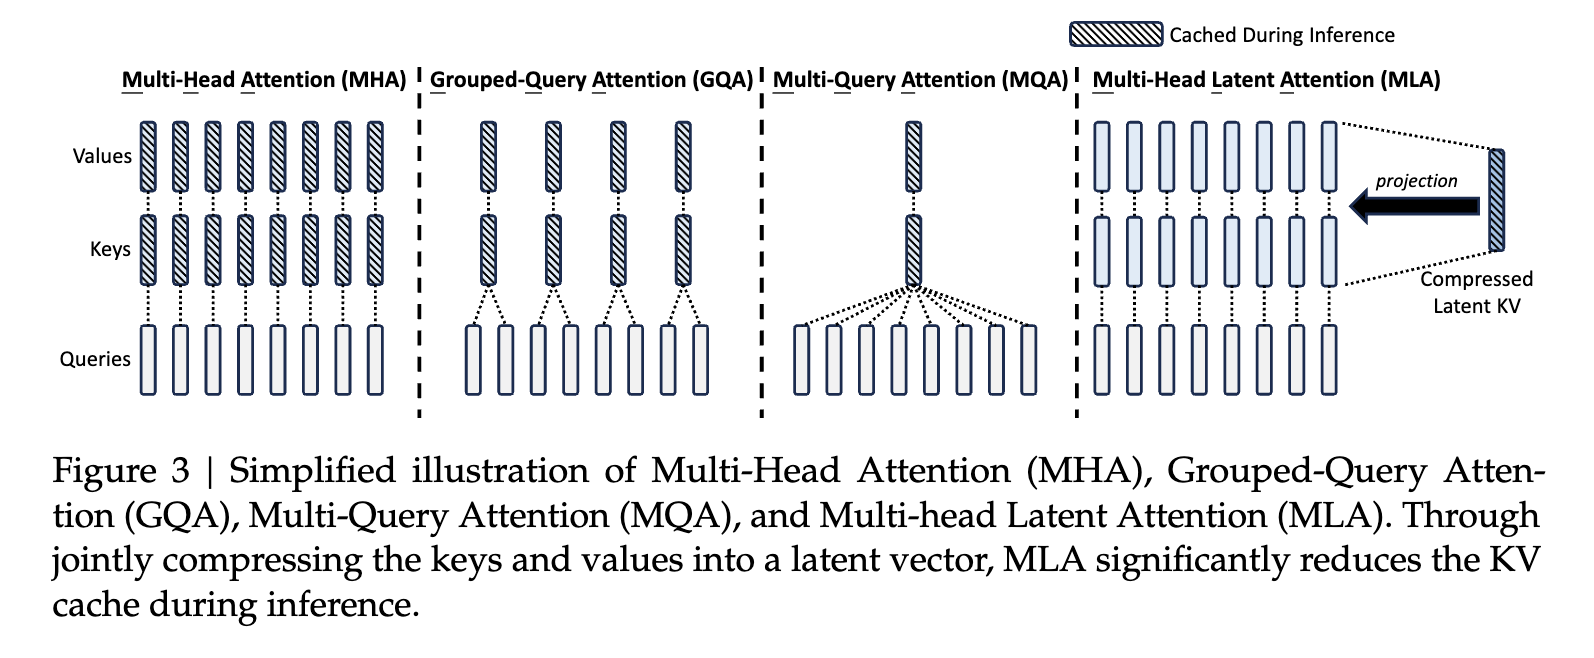
我们还是从 KV-Cache 计算和 FLOPS 复杂度讲起,在标准的多头注意力缓存中,需要 KV 缓存一个庞大的 K 和 V 矩阵 ($\mathbb{R}^{N \times D}$):
- 首先,矩阵大小和输入数据的长度 $N$ 成正比,即随着输入 sequence 的增大,缓存的矩阵大小也会同比增大。
- 其次,$D$ 作为特征维度,往往是一个非常高维的数字,动辄几千或者几万。
因此,DeepSeek 希望从 Hidden Dimension 出发,尝试在不像 MQA 和 GQA 的基础上,减少 KV-Cache 的比例。
从做法上,MLA 会将输入的 hidden dim 首先压缩到一个非常小的向量维度上,再升维度进行 attention 操作,从而使得需要被缓存的 KV 矩阵的 size 非常小:
- $\mathbf{c}_t^Q = W^{DQ}\mathbf{h}_t$: 给定高维空间下的输入向量 $h_t$, 向量左乘一个降维矩阵,得到 $c^Q$
- $[\mathbf{q}_{t,1}^C; \mathbf{q}_{t,2}^C; \dots; \mathbf{q}_{t,n_h}^C] = \mathbf{q}_t^C = W^{UQ}\mathbf{c}_t^Q$: 将得到的 $\mathbf{c}_t^Q$ 进行升维和多头切分
- 可以对比一下,如果把两个向量合并起来,就是 $[\mathbf{q}_{t,1}^C; \mathbf{q}_{t,2}^C; \dots; \mathbf{q}_{t,n_h}^C] = \mathbf{q}_t^C = W^{UQ}\mathbf{c}_t^Q = W^{UQ} W^{DQ} \mathbf{h}_t$,本质上等于多头注意力中的 $\mathbf{q}_{t,i} = W_i^Q \mathbf{h}_t$
- 于此同时,会做 RoPE 的旋转位置编码: $[\mathbf{q}_{t,1}^R; \mathbf{q}_{t,2}^R; \dots; \mathbf{q}_{t,n_h}^R] = \mathbf{q}_t^R = \text{RoPE}(W^{QR}\mathbf{c}_t^Q)$
- 最终,两部分会 concat 成完整的拼接后的 Query 向量
- $\mathbf{q}_{t,i} = [\mathbf{q}_{t,i}^C; \mathbf{q}_{t,i}^R]$
- 同样的,对于 KV 矩阵,也需要进行降维操作:
- $\mathbf{c}_t^{KV} = W^{DKV}\mathbf{h}_t$ 作为低秩压缩的向量,相比于 hidden dim 压缩了很多的维度
- $[\mathbf{k}_{t,1}^C; \mathbf{k}_{t,2}^C; \dots; \mathbf{k}_{t,n_h}^C] = \mathbf{k}_t^C = W^{UK}\mathbf{c}_t^{KV}$ 还原升维操作
- 共享 Rope: $\mathbf{k}_t^R = \text{RoPE}(W^{KR}\mathbf{h}_t)$ 区别于 Q 矩阵的 Rope 编码是针对不同的 $W^{QR}\mathbf{c}_t^Q$ 进行的(维度是高维度 && 切分),K 矩阵的 Rope 编码是经过 $W^{KR}$ 这个矩阵进行映射的,所有 k 向量共享相同的 rope 编码
- $\mathbf{k}_{t,i} = [\mathbf{k}_{t,i}^C; \mathbf{k}_t^R]$
- 对 V 矩阵同理:
- $[\mathbf{v}_{t,1}^C; \mathbf{v}_{t,2}^C; \dots; \mathbf{v}_{t,n_h}^C] = \mathbf{v}_t^C = W^{UV}\mathbf{c}_t^{KV}$
对于上述的算法描述,之需要缓存的部分是 $c^{KV}_{t}$ 和 ${k}_t^R$, 例如对于第 $i$ 个多头, $\mathbf{q}_{t,i}^C$ 需要和之前的每一个 $\mathbf{k}_{j,i}^C (j \le i)$ 进行点积计算,根据矩阵乘法结合律:$\mathbf{q}^T \mathbf{k}^C = \mathbf{q}^T (W^{UK} \mathbf{c}^{KV}) = (\mathbf{q}^T W^{UK}) \mathbf{c}^{KV} = ((\mathbf{c}_t^Q)^T (W^{UQ})^T W^{UK}) \mathbf{c}^{KV}$, 两个矩阵可以吸收成一个矩阵乘法,加速运算。
最终,对于 attention score 的输出:$\mathbf{o}_{t,i} = \sum_{j=1}^{t} \text{Softmax}_j \left( \frac{\mathbf{q}_{t,i}^T \mathbf{k}_{j,i}}{\sqrt{d_h^C + d_h^R}} \right) \mathbf{v}_{j,i}^C$, $W^{UV}$ 矩阵可以和 $W^O$ 矩阵吸收,保证 MLA 在极大减少缓存占用的同时,提升 模型推理的速度。
相当于提取出来 $W^{UV}$ 矩阵出来,让尽可能多的数学等价运算可以在低维空间中进行。
Sparse Attention
接下来,我们来讲一类非常特殊的 attention 加速优化,叫做 sparse attention。
传统的 Self-Attention 需要让序列中的每一个 Token 都与序列中的所有 Token 计算相关性(即 $N \times N$ 的全连接注意力矩阵),而 Sparse Attention 限制了注意力关系的连接密度,只让每个 Token 关注特定范围或规则的 Token。
因此,在这类优化下,每一个 token 的计算,不需要关注之前所有时间步上的 token,因此计算复杂度可以从 $O(N^2)$ 降低到 $O(N \log N)$ 甚至 $O(N)$ 的复杂度。
可以看见,Sparse Attention 在做减法,语义信息肯定没有 Full Self-Attention 丰富,因此 Sparse Attention 设计的好坏就是看在减少计算复杂度的前提下,能否尽可能保持模型语义信息的不丢失。
Tradition Sparse Attention
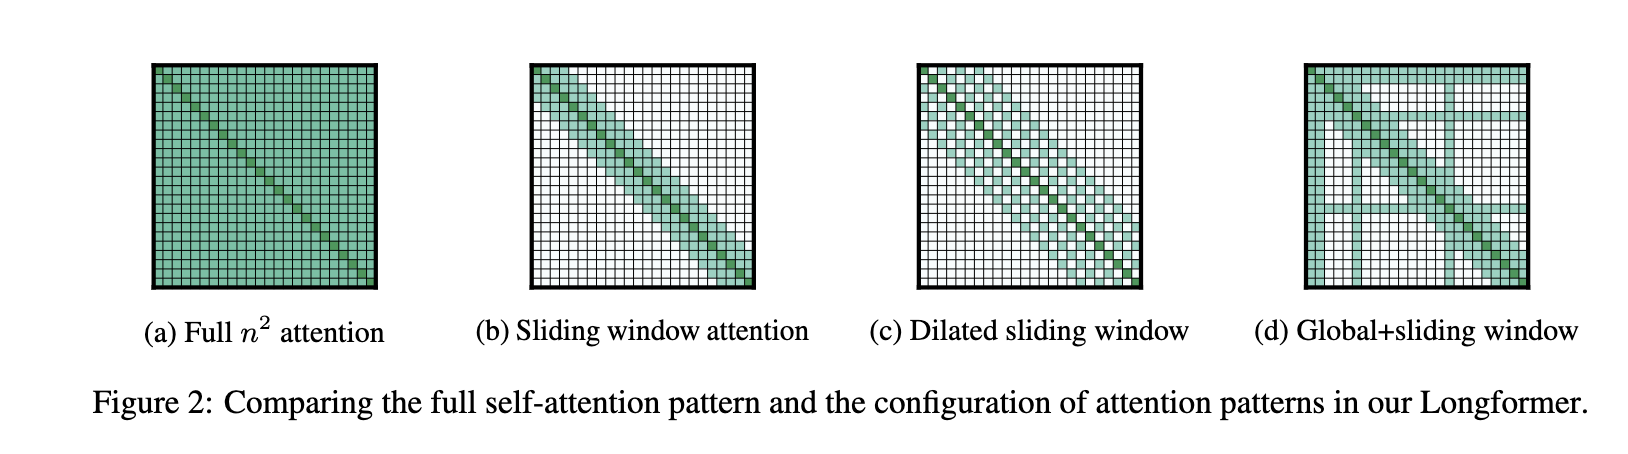
- Sliding Window Attention (SWA):
- 每一个 token 只能看到之前的 $K$ 个 token 的上下文,而不是全部的上下文
- 这样就保证,KV 缓存和单个 token 的计算量不会随着总上下文长度的增大而增大,因此可以保证整体 Attention 是线性的 Attention!
- 同样,在 KV Cache 存储的过程中,被缓存的矩阵的旧行会被不断的替换,采取一种轮转的策略
- 单个的 Sliding Window Attention 无法处理长上下文的输入,但是可以类似卷积神经网络的做法,堆叠很多层,这样就可以容纳很多的信息。(提升感受野的方式)
- Strided / Dilated Attention(步长/膨胀注意力)
- 原理:类似于 CNN 中的膨胀卷积(Dilated Convolution)。Token 不再只看紧挨着的邻居,而是隔几个 Token 采样一个(例如隔 $k$ 个 Token 取一次 KV)。
- 作用:用同样的窗口大小 $W$,获得了成倍放大($k \times W$)的跨度覆盖,能够以较低成本捕捉更远距离的周期性或大颗粒度信息。代表模型如 Sparse Transformer。
- Block-Sparse Attention(分块稀疏注意力)
- 原理:将整个 $N \times N$ 的 Attention 矩阵切分为若干个固定的 $B \times B$ 小方块(Block),只在特定位置的方块内计算全 Attention,其余方块直接 Mask 掉。
- 优势:对 GPU 硬件极度友好。在 Tensor Core 上,处理连续的矩阵块效率远高于分散的稀疏点阵(如 OpenAI 早期开源的 Block Sparse GPU Kernels)。
LongFormer
LongFormer 4 是一种经典的 Sparse Attention 的工作,他主要实现了 SWA, Strided Attention 和 Global Attention 等等的组合:
- Sliding Window Attention
- Dilated Sliding Window: 膨胀滑动窗口,每隔 d 个 token 跳跃,可以极大的提升感受野
- Global Attention: 对于一些全局的信息,所有的 attention 计算都要包含,且这些 token 的计算会和全局的所有 token 进行计算,同时,Global Attention 使用了不同的 QKV Projection Matrix,保留了更丰富的全局信息。
Streaming LLMs
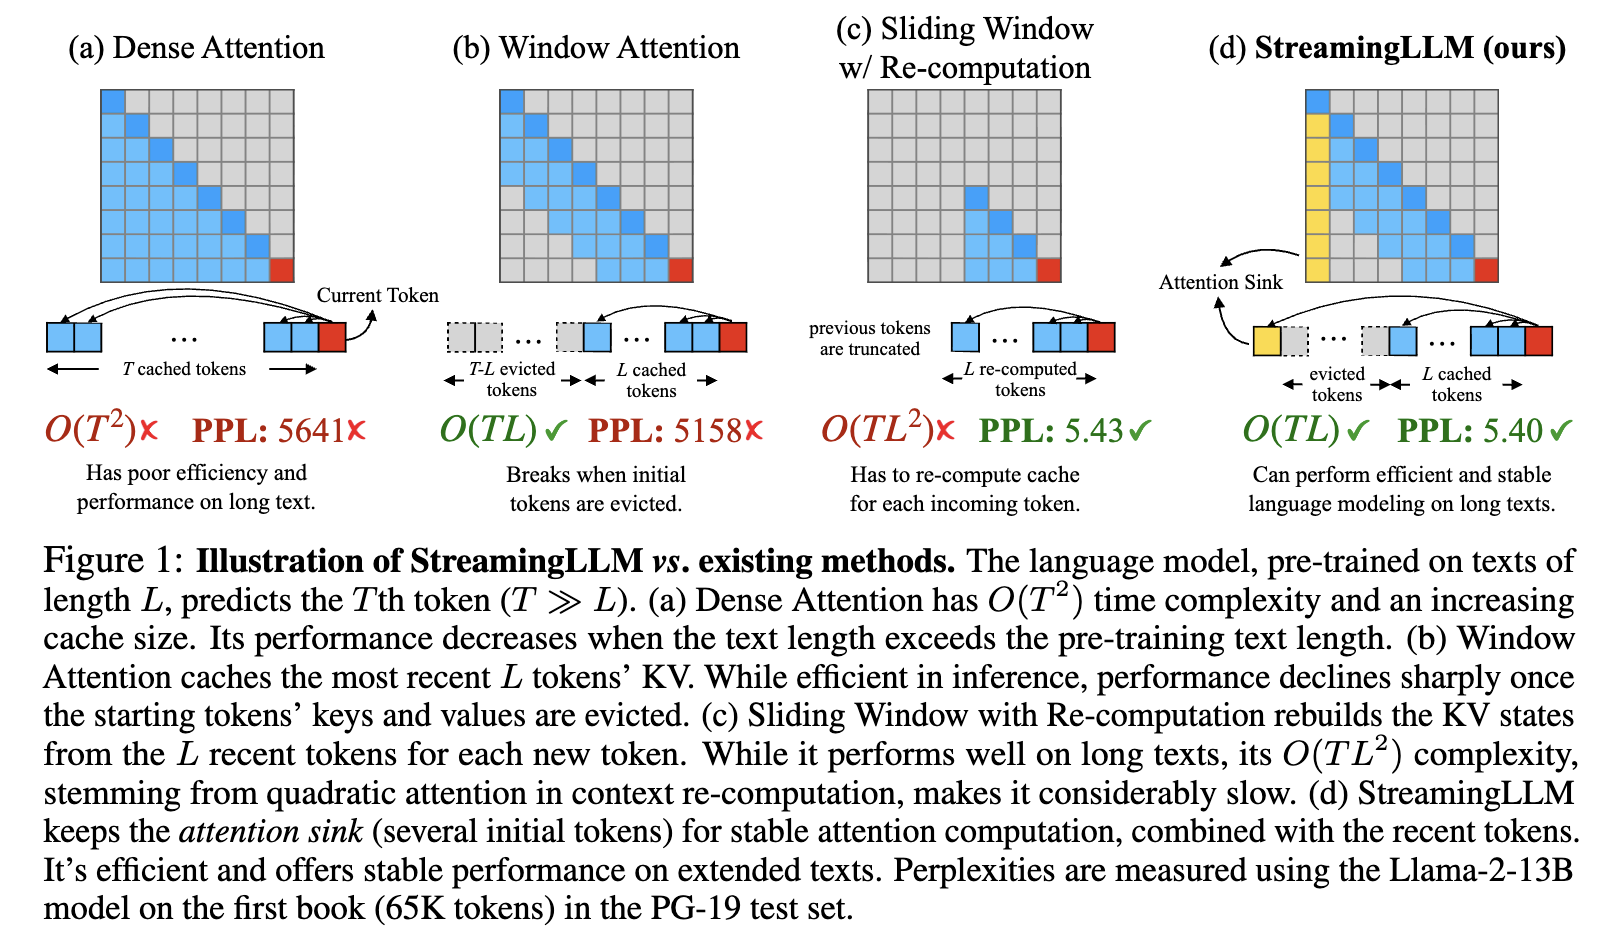
Streaming LLMs 5
Attention Sink
作者在研究 Window Attention 的时候发现了很多退化现象:
- 一旦 Window Attention 超过了 KV-Cache Size,前面的一开始的 token 会被丢弃,会出现 PPL 的快速上升
- 无论是 Dense Attention 还是 Window Attention,PPL 都会在超过 pre-train length 的时候出现陡增的情况
- 如果 SWA 不实现 KV-Cache 的复用,而是进行一种 Recomputation,模型的 PPL 可以获得有效的降低,但是此时运行的时间复杂度会变大
Based on the above insights, we propose StreamingLLM, a simple and efficient framework that enables LLMs trained with a finite attention window to work on text of infinite length without finetuning.
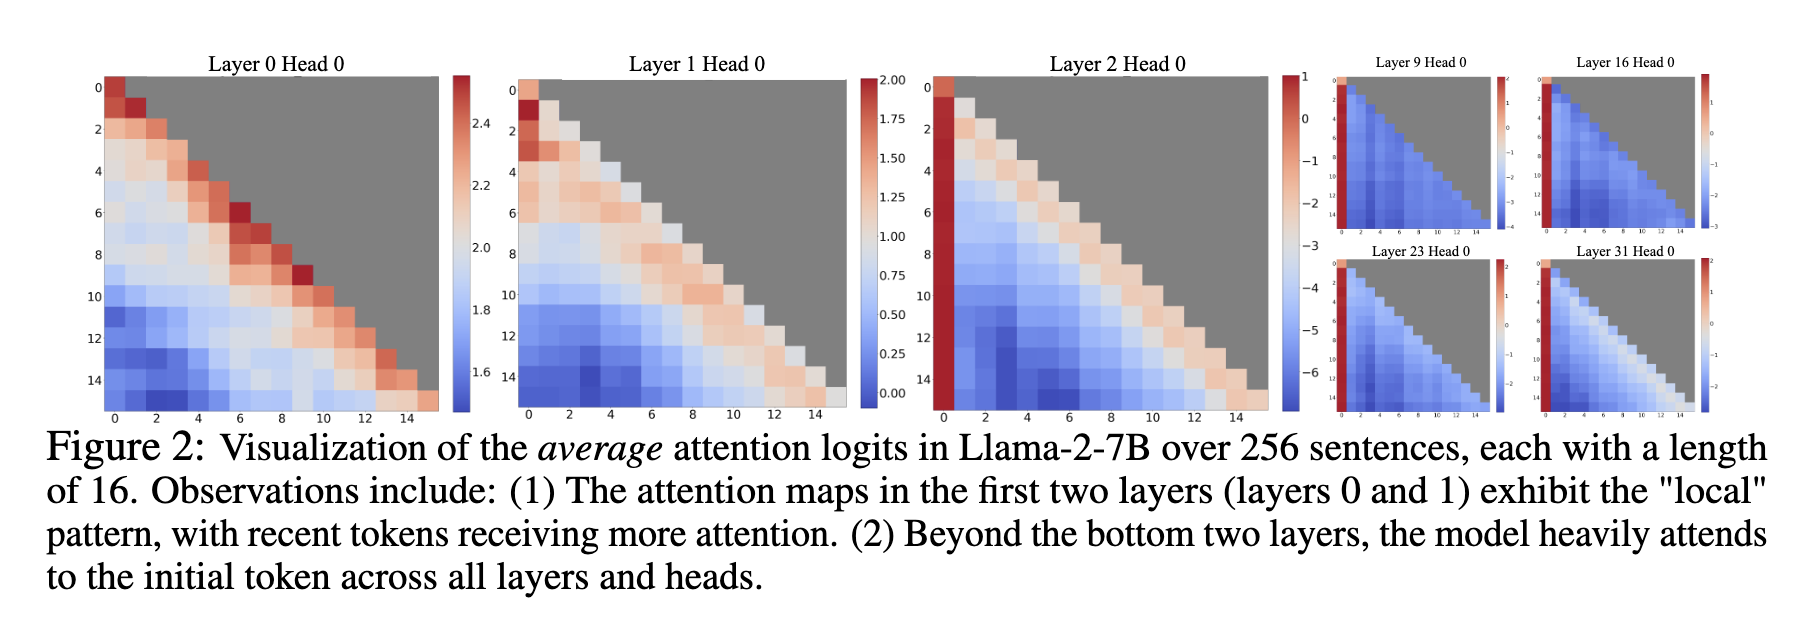
Attention Sink 是研究者在发现预训练模型 Attention 分配不均匀的过程中,呈现的一种 Attention 分布的现象:在一般情况下,模型会根据语义相关性进行 Attention Score 的分配然后进行归一化,但是,模型会将前几个 token 当作 “垃圾桶”,即残留的 attention 分数会 sink 到全面的几个 token 中。
Attention Sink 现象可以很好的解释为什么我们不可以采用轮转 SWA 的方式进行 KV Cache 阶段,因为大量的 Attention Sink 会被丢弃(在长上下文中) 因此,Streaming LLM 添加了 Attention Sink 的 token,保证这些 token 始终被计算在 attention 里面(相当于一种全局注意力),可以保证 Attention Sink 的分布不会被破坏。
于此同时,Attention Sink 还可以被利用在训练中,即在训练中引入 sink-token,可以在预训练中充当预训练稳定器的作用。同样,也可以使用 SoftMax-off-by-On 等技巧,来稳定 Attention 计算过程中的 sink 现象。
以上所讲的都是一些经典的 Sparse Attention 的文章,下面我们将介绍 DeepSeek 系列的 NSA 和 DSA,了解最前沿的 Sparse Attention 是如何构建的。
NSA (Native Sparse Attention)
NSA 6 是 DeepSeek 在 2025年年初提出的一种相对前沿的稀疏注意力方法。Sparse Attention 应该在训练时引入,而不是一种简单的 training-free 的方法(这也是训推一致性的一种体现)
- 现有的 training-free 方法会导致模型分数降低,因为 pre-train 阶段,模型是通过 full-attention 来进行计算的
- 但是将现有的稀疏注意力方法引入训练中,会导致 flash-attention 等优化无法被 apply,导致训练效率下降
同时,论文也强调了 Arithmetic Intensity 这个概念,代表计算操作数和内存访问数的比例,如果太高,则 FLOPS 受限,如果太低,则内存通信受限。
在 DSA 中,Attention 由下面三个 Attention 进行加权得到:
$$\text{Attention}(q, K, V) = g_c \cdot \text{Attn}(q, \tilde{K}_c, \tilde{V}_c) + g_s \cdot \text{Attn}(q, K_s, V_s) + g_w \cdot \text{Attn}(q, K_w, V_w)$$- $\tilde{K}_c, \tilde{V}_c$ 代表经过压缩(Compression)后的全局键值对。
- $K_s, V_s$ 代表通过动态选择(Selection)挑选出的关键 Token 块。
- $K_w, V_w$ 代表滑动窗口(Sliding Window)内的局部键值对。
- $g_c, g_s, g_w$ 是由门控机制(Gate)动态计算出的权重系数,用于平衡三个分支的贡献。
接下来,我们详细讲解公式中的 3 个 compression:
- Token Compression(按照 Block 分块进行注意力的 Compression,有点类似于卷积操作)
- 对于 $:t$ 的全部 token,会按照 $l$ 作为分块的长度进行 blocking
- 每一次 compress 的压缩范围是 $[id + 1, id + l]$, 这里设置 $l > d$ 可以保证压缩区间之间存在重叠,避免边缘信息被裁减。
- $\varphi$ 是一个可学习的 MLP(多层感知机),并且带有块内位置编码(intra-block position encoding)。它的作用是把一个包含 $l$ 个 Token 的局部 Key 块,通过神经网络映射并融合成单个压缩 Key 向量。
- 输入维度 $[l, d_k]$, 输出维度 $[d_k]$ (不考虑多头和 batch size 的话)
- $$\tilde{K}_t^{\text{cmp}} = f_K^{\text{cmp}}(\mathbf{k}_{:t}) = \left\{ \varphi(\mathbf{k}_{id+1:id+l}) \middle\vert{} 0 \leqslant i \leqslant \left\lfloor \frac{t-l}{d} \right\rfloor \right\}$$
- Token Selection
- 在 Selection 过程中,依然是 block-based selection 来加速 GPU 硬件的加速
- 假设 $l'$ 是 token selection 的分块长度,$l$ 是 token compression 的分块长度,$d$ 是原始分块的长度,且 $d$ 是 $l$ 和 $l'$ 的因数。
- $p_t^{cmp} \in \mathbb{R}^{\left\lfloor \frac{t-l}{d} \right\rfloor}$ 是 compress 后形成的注意力得分,注意因为我们分了 block,所以这个矩阵的维度是除以了 block-size $d$ 的 (但是单次 compress 的长度大于 $d$)
- Selection Block 会做一个 Pooling 的操作
- $$\mathbf{p}_t^{\text{slc}}[j] = \sum_{m=0}^{\frac{l'}{d}-1} \sum_{n=0}^{\frac{l}{d}-1} \mathbf{p}_t^{\text{cmp}}\left[ \frac{l'}{d}j - m - n \right]$$
- 注意,selection block 本身就包含很多 block,但是 selection block 本身是不重叠的
- 对于多头注意力来说,例如 MQA 和 GQA,往往涉及共享 KV-Cache 的优化,如果多头之间涉及注意力的共享,那需要对 selection 对 kv-cache 进行一次head 之间的合并,避免资源碎片。
- 最终,会做 top-n 的 selection,将这部分 block 的 kv 不压缩,直接进入 attention 计算
- Sliding Window Attention 正常的操作
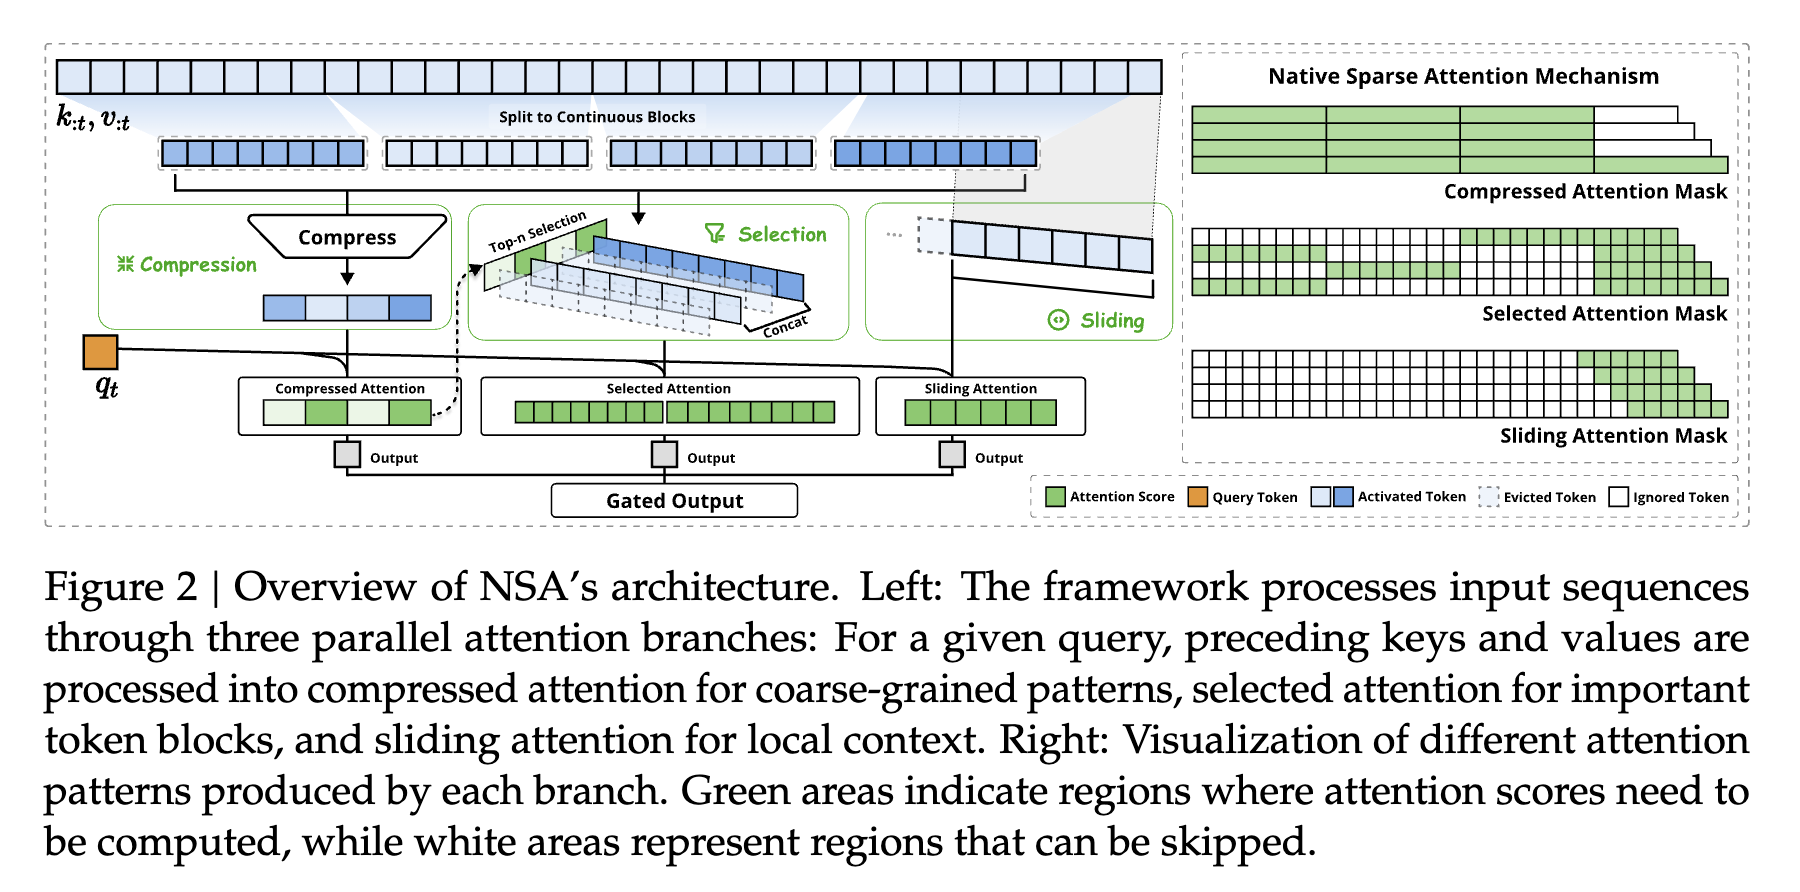
于此同时,NSA 还针对 Flash Attention 等进行了大量工程上的加速优化,这一部分将会和 Flash Attention 一起整理呈现。
DSA (DeepSeek Sparse Attention, DeepSeek-V3.2)
Compared with DeepSeek-V3.1-Terminus, the last version of DeepSeek-V3.1, the only architectural modification of DeepSeek-V3.2 is the introduction of DeepSeek Sparse Attention (DSA) through continued training.
DSA 7 是 DeepSeek-V3.2 引入的稀疏注意力。首先,我们来看基础的 MLA 版本和 MQA 和 MLA 结合的版本,唯一的差异就是降维的 $c_t^{KV}$ 不需要完成重新通过一个投影矩阵投影到 K 和 V 的高维向量后再切分为多头。
MLA 的 MQA 变体不会引入新的 KV-Cache 计算,因为 KV-Cache 计算已经在 $c_t^{KV}$ 中完成了。
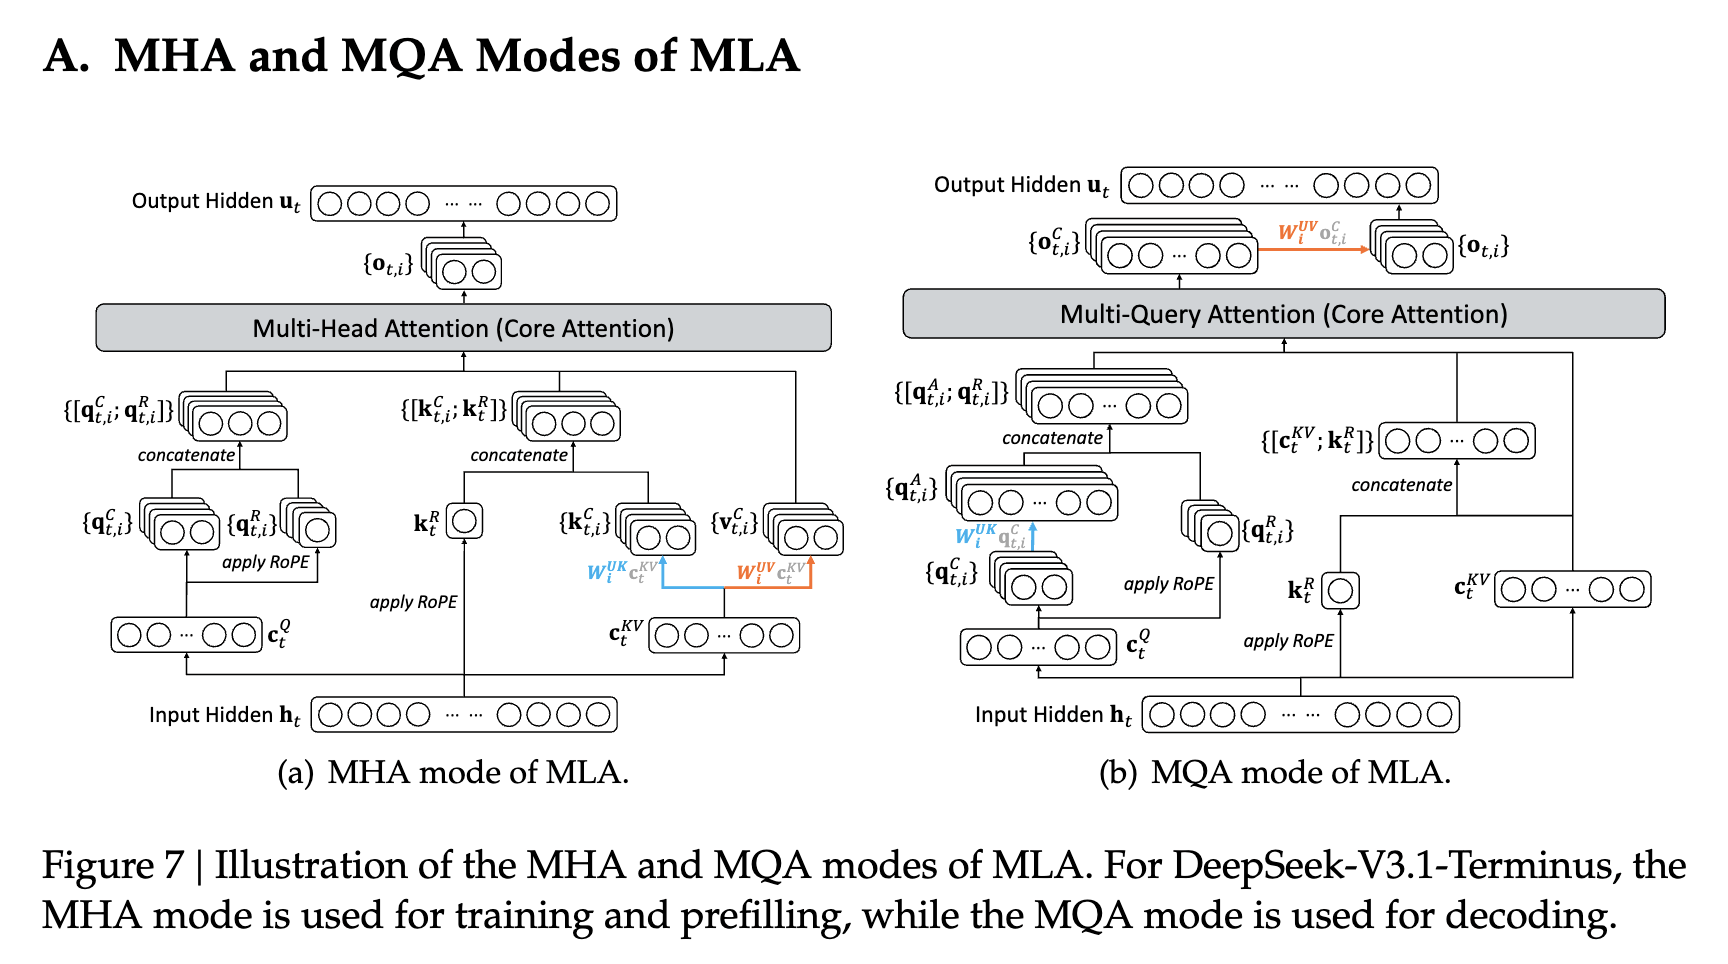
我们来看基于 MQA 版本的 MLA 实现,对 q 的处理(升维降维 和 rope 处理)保持完全一致。关键架构改进在于:
- Lightning Indexer:
- 首先通过轻量级的低维投影或计算,对每个查询(Query)和所有历史键(Key)快速打分,评估它们之间的相关性。
- 这一步开销很小,类似于“粗筛”,迅速锁定哪些历史片段可能是相关的。
- Top-k 动态选择与稀疏计算:
- 接着,根据索引器的评分,为每个查询动态挑出最重要、分数最高的 $k$ 个 Token。(类似于一个 KV 压缩的部分)
我们来看索引器,给定计算查询词元 $\mathbf{h}_t$ 与历史词元 $\mathbf{h}_s$ ,Indexer 打分的公式是:
$$I_{t,s} = \sum_{j=1}^{H^I} w_{t,j}^I \cdot \text{ReLU}(\mathbf{q}_{t,j}^I \cdot \mathbf{k}_s^I)$$- $H^I$ 表示索引器头的数量(index heads)
- $\mathbf{q}_{t,j}^I$ 和 $w_{t,j}^I$ 是由查询词元 $\mathbf{h}_t$ 派生出的向量和权重,$\mathbf{k}_s^I$ 是由历史词元 $\mathbf{h}_s$ 派生出的键向量。
- 由于使用的 Relu 函数吞吐量高,并且可以降低成 FP8 进行计算,因此这一步运算完成的速度非常快。
在得到相关性分数之后,只需要选择分数最高的 top-k,取 $\{\mathbf{c}_s\}$ 作为进入 Attention 计算的 K 和 V。
$$\mathbf{u}_t = \text{Attn}(\mathbf{h}_t, \{\mathbf{c}_s \mid I_{t,s} \in \text{Top-k}(I_{t,:})\})$$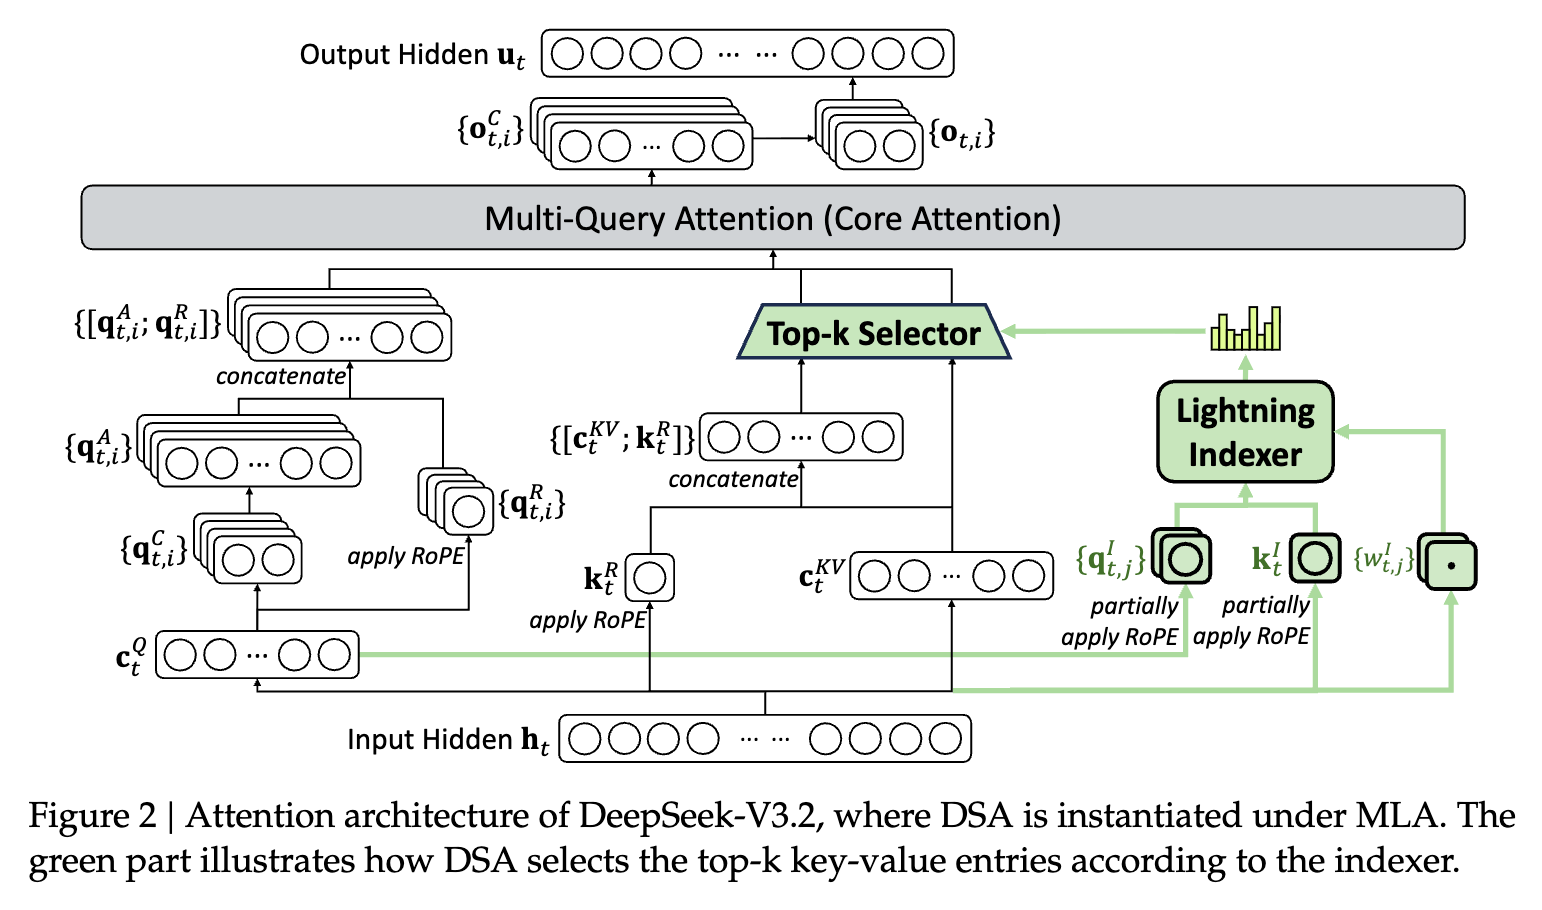
Minimax Sparse Attention (Minimax M3)
Minimax 在 2026年6月发布了 Minimax-M3,在 M2 回归 full-attention 之后,M3 再一次引入了稀疏注意力的机制,Minimax Sparse Attention 8。
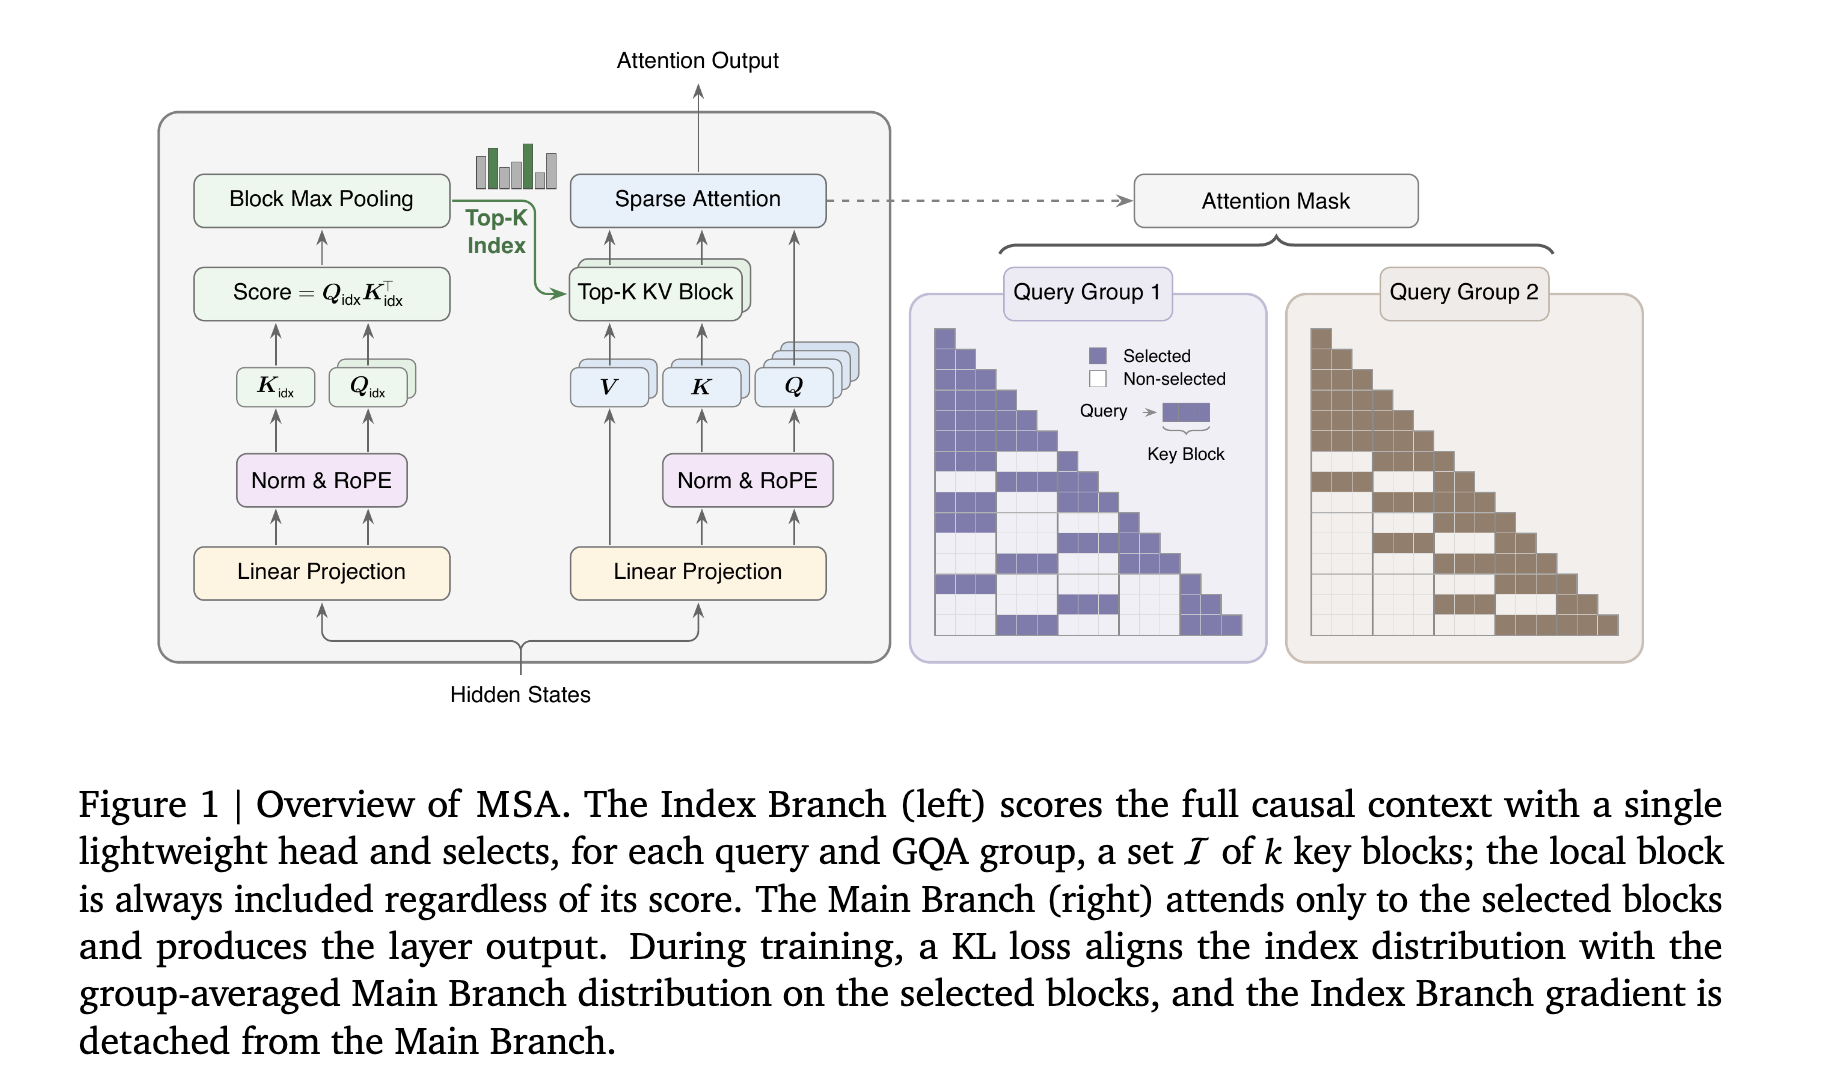
MSA 在主分支之前依然包含索引器的步骤,通过索引器选择最关键的 token 作为稀疏注意力。注意,MSA 中的索引计算是通过 token 块 而不是 单个 token 作为核心的计算单元,来提升索引的速度。
Compressed Sparse Attention (DeepSeek-V4, V4.1)
DeepSeek-V4 Tech Report
https://arxiv.org/pdf/2606.19348
GLM-5.3 Attention (GLM-5.3-Flash)
https://z.ai/blog/glm-5.3-flash
Qwen Sparse Attention (Qwen-3.8-Flash-Next)
Linear Attention
Basic Linear Attentions
Linear Attention 从另一个视角解决了这个问题,我们首先从最基本的 Linear Attention 计算原理出发。
考虑最基本的因果掩码的 Attention 计算,一对注意力的计算公式如下:
$$Y_i = \frac{\sum_{j=1}^{i} \exp(Q_i K_j^T) V_j}{\sum_{j=1}^{i} \exp(Q_i K_j^T)}$$我们假设我们对架构做如下改进,引入函数 $\phi$
$$ Y_i = \frac{\sum_{j=1}^{i} \left( \phi(Q_i K_j^T) \right) V_j}{\sum_{j=1}^{i} \phi(Q_i K_j)^T} $$同时,我们规定 $\phi(x)$ 具备很好的吸收性质: $\phi(xy) = \phi(x) \phi(y)$,因此,上式可以展开为:
$$Y_i = \frac{\sum_{j=1}^{i} \left( \phi(Q_i) \phi(K_j)^T \right) V_j}{\sum_{j=1}^{i} \phi(Q_i) \phi(K_j)^T} = \frac{ \phi(Q_i)\sum_{j=1}^{i} (\phi(K_j)^T V_j)}{\phi(Q_i) \sum_{j=1}^{i} \phi(K_j)^T}$$注意 这里 $\phi(Q_i)$ 不可以被约掉,因为上下都是向量的乘法。
我们考虑一个新的 token 计算是,需要做什么样的计算:
- 首先需要计算 $\phi(Q_i)$, $\phi(K_i)$
- 此时,新 token 不需要和过去的 token 做 attention 计算,只需要取出对应缓存的 $\phi(K_j)^T V_j$ 的部分和对应的分母求和,求出 $Y_i$
- 因此,此时新 token 的计算是 $O(1)$ 级别的时间复杂度。
RNN View
我们从 RNN 的视角思考这个结构。我们把上面公式里括号内的累加项定义为两个固定大小的矩阵状态:
- 隐状态矩阵 $S_i = \sum_{j=1}^{i} \phi(K_j)^T V_j$
- 归一化向量 $Z_i = \sum_{j=1}^{i} \phi(K_j)^T$ 由于这是从 $1$ 到 $i$ 的逐步累加,它天然就具备了递推特性。每当新来一个词 $i$ 时,我们根本不需要回头去看所有历史数据,只需要用上一个时刻的状态进行极其简单的更新:
从 RNN 的视角分析,在每一次新 token 计算时,过往的所有 token 信息全部被引入到一个固定大小的隐状态矩阵中 $S_i$, 因此,在长上下文时会存在信息损失。
Mamba
我们从 RNN 的视角规范化 Linear Attention 的迭代:
- 隐状态的更新: $h(t) = f(h_{t-1}, x_t)$
- 前向计算,更新出当前的输出: $y_t = g(h_t, x_t)$
在 Linear Attention 中,更新结构的函数如下:
- $h(t) = h(t-1) + \phi(K_i)^T V_i$
- $y(t) = \phi(Q_i) h(t)$
我们考虑隐状态的更新公式: $h(t) = h(t-1) + \phi(K_i)^T V_i$,我们可以把隐状态的更新当做是:
- 过去的历史状态
- 此步骤引入的新状态
很显然,Linear Attention 的更新是一个相对粗糙的步骤,两者进行简单的加和,导致模型无法学到很好的注意力分布。
在 Mamba9 论文中,提出了一种更新的架构,具体公式表示如下:
$$ h_t = A_t h_{t-1} + B_t x_t $$$$ y_t = C_t $$其中关键的参数变量 $A_t$, $B_t$, $C_t$ 都是依赖当前状态步骤下的 $t$ 输入。
We identify that a key weakness of such models is their inability to perform content-based reasoning, and make several improvements. First, simply letting the SSM parameters be functions of the input addresses their weakness with discrete modalities, allowing the model to selectively propagate or forget information along the sequence length dimension depending on the current token.
然而,由于 Mamba 的架构创新属于比较激进的结构创新,且目前暂不属于主流的 LLM 架构,因此暂时不作为核心内容介绍。
Mamba2
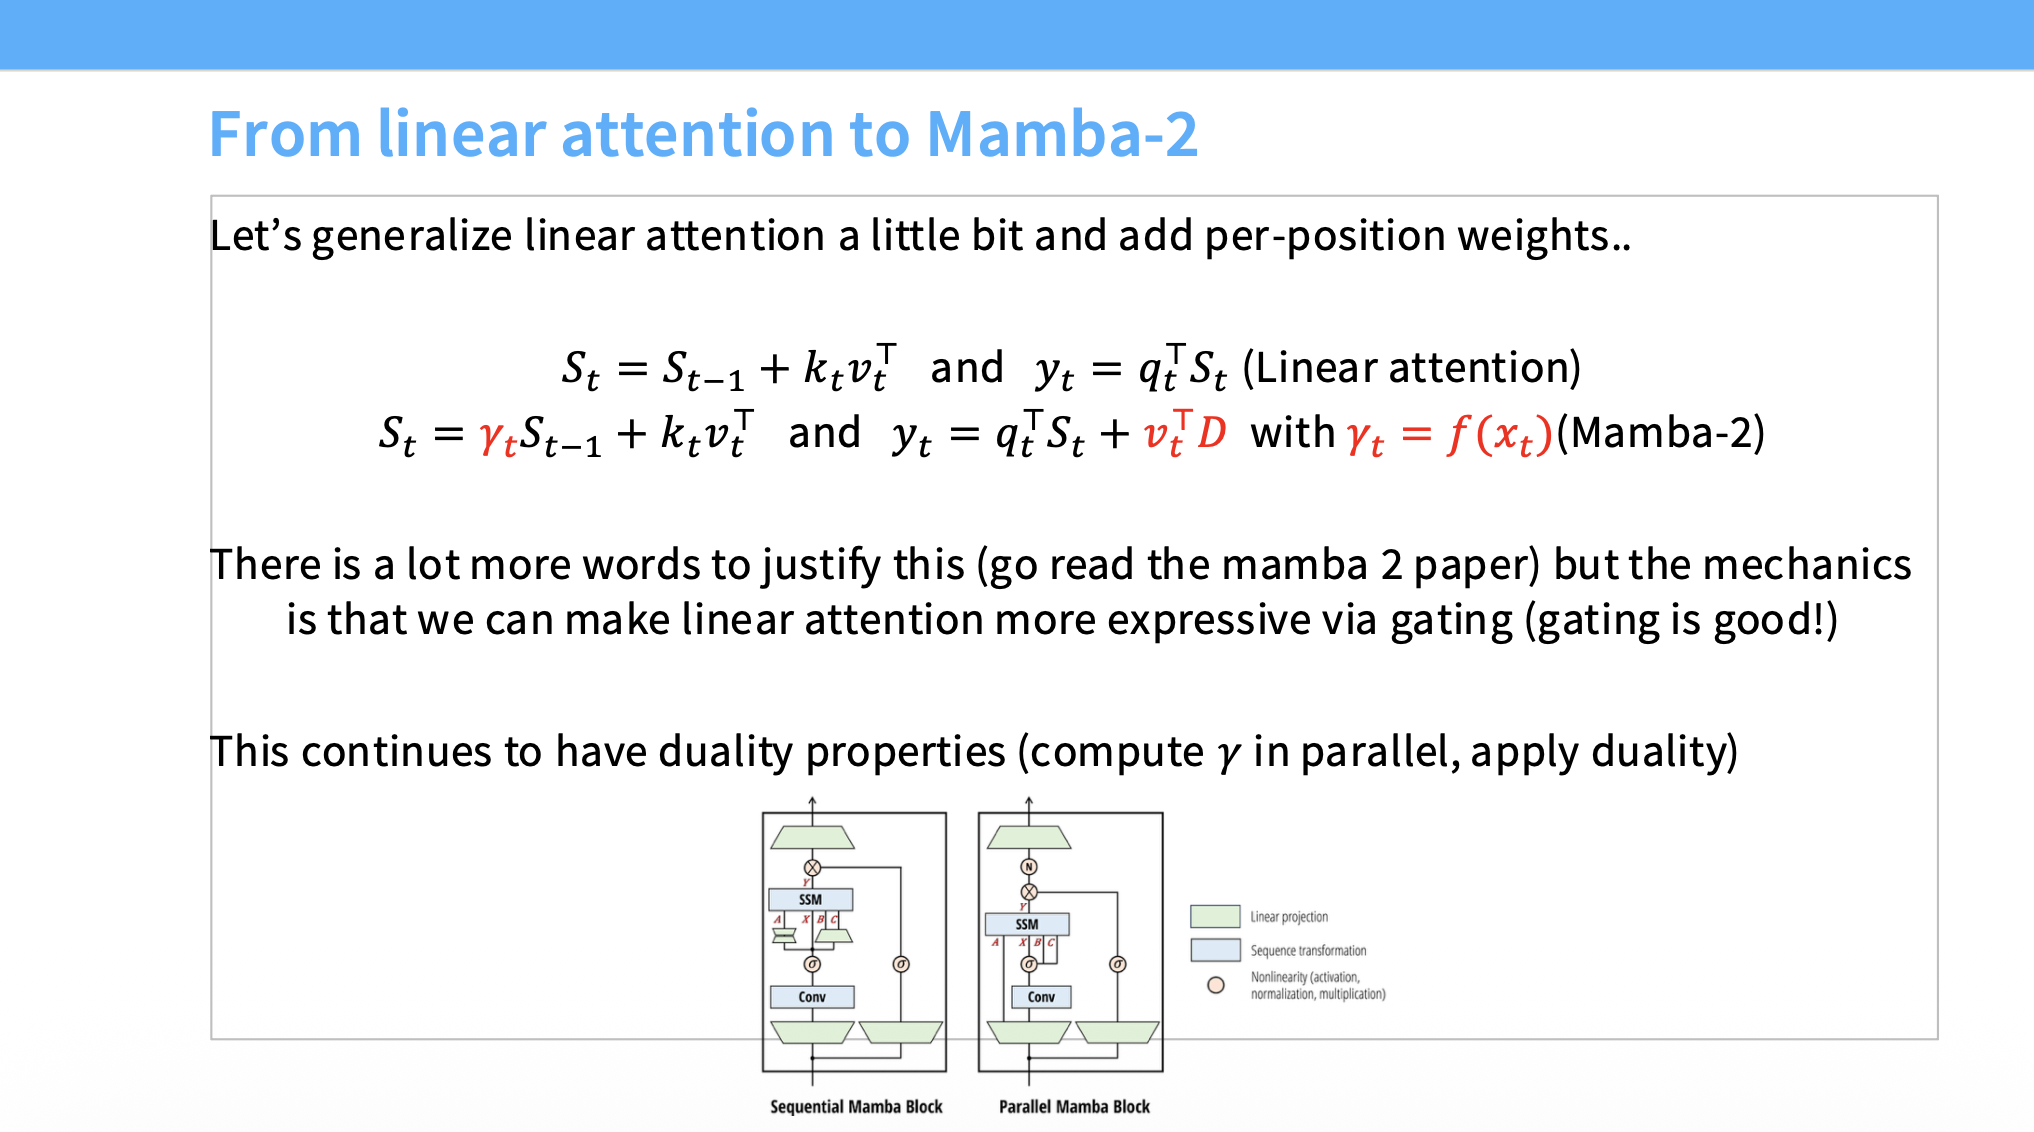
Mamba210 仍然保持相同的整体更新策略,和 Mamba1 结构非常类似。只不过这一次在输出层引入优化。
Gated Delta Net
在介绍 Gated DeltaNet 的基础之上,我们先介绍基本的 DeltaNet 结构:论文 Linear Transformers Are Secretly Fast Weight Programmers 11 将上述核函数形式的 linear attention 和九十年代的 fast weight controllers 结合,作者首先针对当前 Linear Attention 的结构,提出了如下局限性:
- Linear Attention 本质上是维护一个隐状态矩阵 $S_t$, 这个矩阵能够维持的信息是有限的,无法应对持续增长的上下文。从正交性的角度解释,当序列长度超过了对应 key 的 dimension length,就处于一种过容量状态。此时,模型会被迫学会更新当前的容量状态。
https://arxiv.org/pdf/2406.06484
Kimi Delta Attention
Flash Attention
https://arxiv.org/pdf/2205.14135 https://arxiv.org/pdf/2307.08691 https://arxiv.org/pdf/2407.08608 https://arxiv.org/pdf/2603.05451 https://github.com/dao-ailab/flash-attention
What is the Frontier?
- Kimi (Kimi-K3, Kimi Delta Attention): https://arxiv.org/pdf/2607.24653
- Qwen (Qwen-3.8-Flash-Next, GDN & Qwen Sparse Attention): https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
- GLM (GLM-5.3-Flash): https://z.ai/blog/glm-5.3-flash
- DeepSeek (DeepSeek-V4.1-Flash, Compressed Sparse Attention): https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
- Minimax (Minimax-M3, Minimax Sparse Attention): https://arxiv.org/abs/2606.13392